IPA公式正解:ウ MAX
※ 正解はIPA公表の解答です。解説は当サイトが生成AIを用いて作成しています。誤りにお気づきの場合はお問い合わせください。
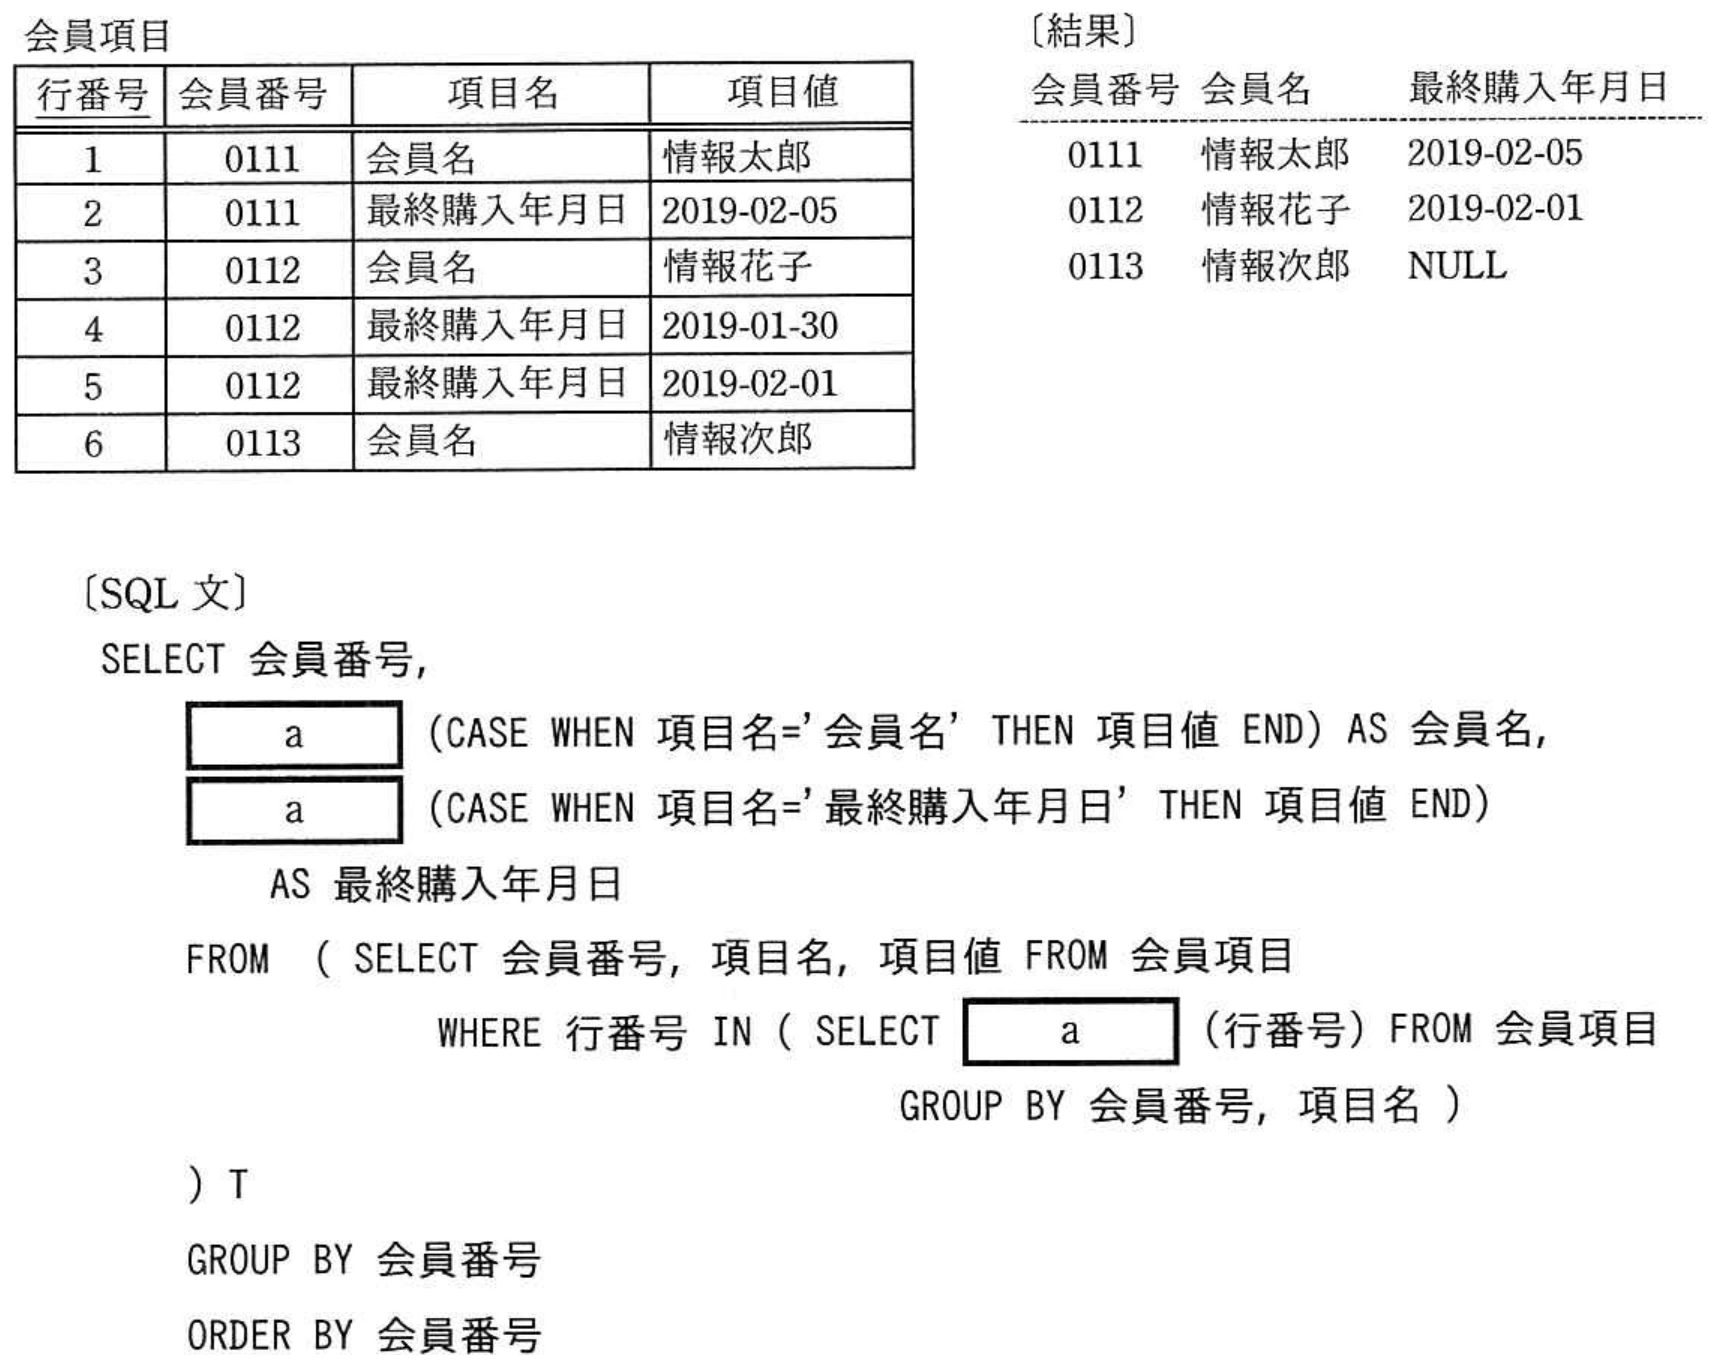
【解説】正解は選択肢【ウ】です。条件(3)「同一“会員番号”で同一“項目名”の行が複数ある場合、より大きい行番号の項目値を採用する」を実現するため、副問合せで「MAX(行番号)」を取得して最新行に絞り込み、外側のSELECT文の集約関数としても「MAX」を用いてグループ化された値を1行に集約します。
【詳細解説】■ 本問の核心・解法のポイント
本問は、EAV(Entity-Attribute-Value)パターンで設計された縦持ちのテーブルを、SQLを用いて横持ち(表形式)に変換・ピボット処理する問題です。
条件(3)より、「同一“会員番号”で同一“項目名”の行が複数ある場合、より大きい行番号の項目値を採用する」必要があります。
内側の副問合せ:
WHERE 行番号 IN (
SELECT a(行番号) FROM 会員項目
GROUP BY 会員番号, 項目名
)
ここでは、会員番号と項目名ごとに最も大きい行番号を特定して重複を排除したいので、最大値を求める集約関数「MAX」が入ります。
外側のSELECT文:
CASE 式を用いて「項目名 = '会員名' THEN 項目値 END」などを判定しています。外側では「GROUP BY 会員番号」が行われているため、会員番号ごとに1行に集約するために集約関数が必要です。該当しない項目名は NULL になるため、NULL を無視して唯一の値を取り出す集約関数として「MAX」を指定します(MAX(NULL, '情報太郎') = '情報太郎' となります)。
したがって、a には共通して MAX が入ります。
・各選択肢の徹底解説:
・ア:COUNT は行数を数える関数であるため、行番号の最大値を取得することも、文字列である項目値を取り出すこともできません。
・イ:DISTINCT は重複行を排除するキーワードであり、GROUP BY の集約関数として単体で「DISTINCT(行番号)」のように記述して最大行番号を絞り込むことはできません。
・【選択肢ウ★】:MAX は最大値を取得する集約関数であり、副問合せでは最大の行番号を特定し、外側のSELECT文ではCASE式の非NULL値を抽出するために正しく機能します。
・エ:MIN を指定すると、より小さい行番号(古い行)が採用されてしまい、「より大きい行番号の項目値を採用する」という条件(3)に反します。
よって正解はウです。