データベーススペシャリスト午後II 総合事例記述平成31年 春期
午後II 問1
問1 ログ分析システムに関するデータベース設計・実装
テーマ:ログ分析システムにおけるテーブル構造の設計・性能評価・物理分割及びクラスタ構成
左右2分割表示:左側の問題文をスクロールしながら右側の設問に解答できます
長文事例本文
図表クリックで拡大問1 データベースの設計,実装に関する次の記述を読んで,設問1〜3に答えよ。
B銀行では,支店の窓口において,預金の入出金,税金・公共料金の収納,振込などの金融サービス業務(以下,窓口業務という)を行っている。現在,行員が使用する窓口業務専用の端末(以下,窓口端末という)で記録されたログを,障害調査,監査などに利用している。今後は,蓄積したログを更に活用して,事務手続,アプリケーションソフトウェア(以下,APという)の改善に役立てるために,ログ分析システムを構築することにした。
〔システムの現状〕
1. 現行システムの構成
(1) 支店は60支店あり,店番で識別している。各支店には,複数の窓口端末がある。窓口端末は,PC,モニタ,スキャナ,プリンタ,現金処理機などを組み合わせた端末で,支店ごとに一意な機番で識別している。
(2) データセンタが1拠点ある。データセンタには,窓口端末サーバ,ホストコンピュータがある。窓口端末サーバでは,全支店の窓口端末の監視,ログ収集,APの配布などを行う運用管理システムが稼働しており,ホストコンピュータでは,業務処理を行う勘定系システムが稼働している。
(3) 支店内,データセンタ内の機器はLANで接続されており,LAN間はWANで接続されている。
(4) 窓口端末のPCでは,窓口端末用のAP(以下,端末APという)が稼働している。端末APは,業務ロジックをもたず,勘定系システムと連動しながら,画面の入出力及び接続機器の制御を行っている。
(5) 端末APでは,預金入金,預金出金,振替などの取引ごとに取引メニューが用意されており,取引は,取引番号で識別している。取引メニューに対応する手続用の画面が複数ある。画面は,全体で一意な画面番号で識別している。
2. ログ収集・利用状況
(1) 窓口端末には,ログを自動的に記録する機能が備わっている。窓口端末のPCは,ログをログファイルに保存し,約15分ごとに窓口端末サーバに転送している。
(2) ログには,店番,機番,タイムスタンプ(以下,TSという),及びログテキストを記録する。ログテキストは,取引番号,画面番号,画面ごとに固有な項目とその値を“[項目ID:項目名=値:値の説明]”(値の説明の表示は任意)の形式で編集した文字列を連結したものである。表1にログの例を示す。
表1 ログの例(一部省略)
| 店番 | 機番 | TS | ログテキスト |
| :--- | :--- | :--- | :--- |
| 1234 | 2501 | 2019-03-15 11:24:11.120 | [201:取引番号=3322:預金出金] [301:画面番号=0777:口座出金依頼] [155:処理区分=001:取引開始] [101:行員番号=1122334:情報花子] [017:科目=2:普通] [005:口座店番=543:○○支店] [006:口座番号=00578212]… |
| 1234 | 2501 | 2019-03-15 11:24:20.098 | [201:取引番号=3322:預金出金] [301:画面番号=0001:依頼書等受領確認] [155:処理区分=055:残高確認依頼] [315:受領結果=1:OK] … |
| 1234 | 2501 | 2019-03-15 11:24:27.211 | [201:取引番号=3322:預金出金] [301:画面番号=0028:通帳受領確認] [018:出金依頼金額=10000:] [155:処理区分=055:残高確認依頼] … |
(3) 窓口端末サーバでは,RDBMSが稼働していて,窓口端末のPCから収集したログファイルのデータを,約1時間ごとに“ログ収集”テーブルに格納している。
(4) 利用者である行員(以下,利用者という)は,店番,機番,及びTSの範囲を指定してテーブルの行を選択し,TS及びログテキストを射影する問合せを行って,障害調査,監査の際に利用している。
〔新たなログ分析システムの構築〕
1. ログ分析システムの主な機能
(1) 蓄積した60か月分のログを対象に,障害調査,監査,事務手続改善,AP改善に用いるデータを抽出するログ分析処理の機能を提供する。表2に,ログ分析処理の例を示す。
表2 ログ分析処理の例
| 処理名 | 内容 |
| :--- | :--- |
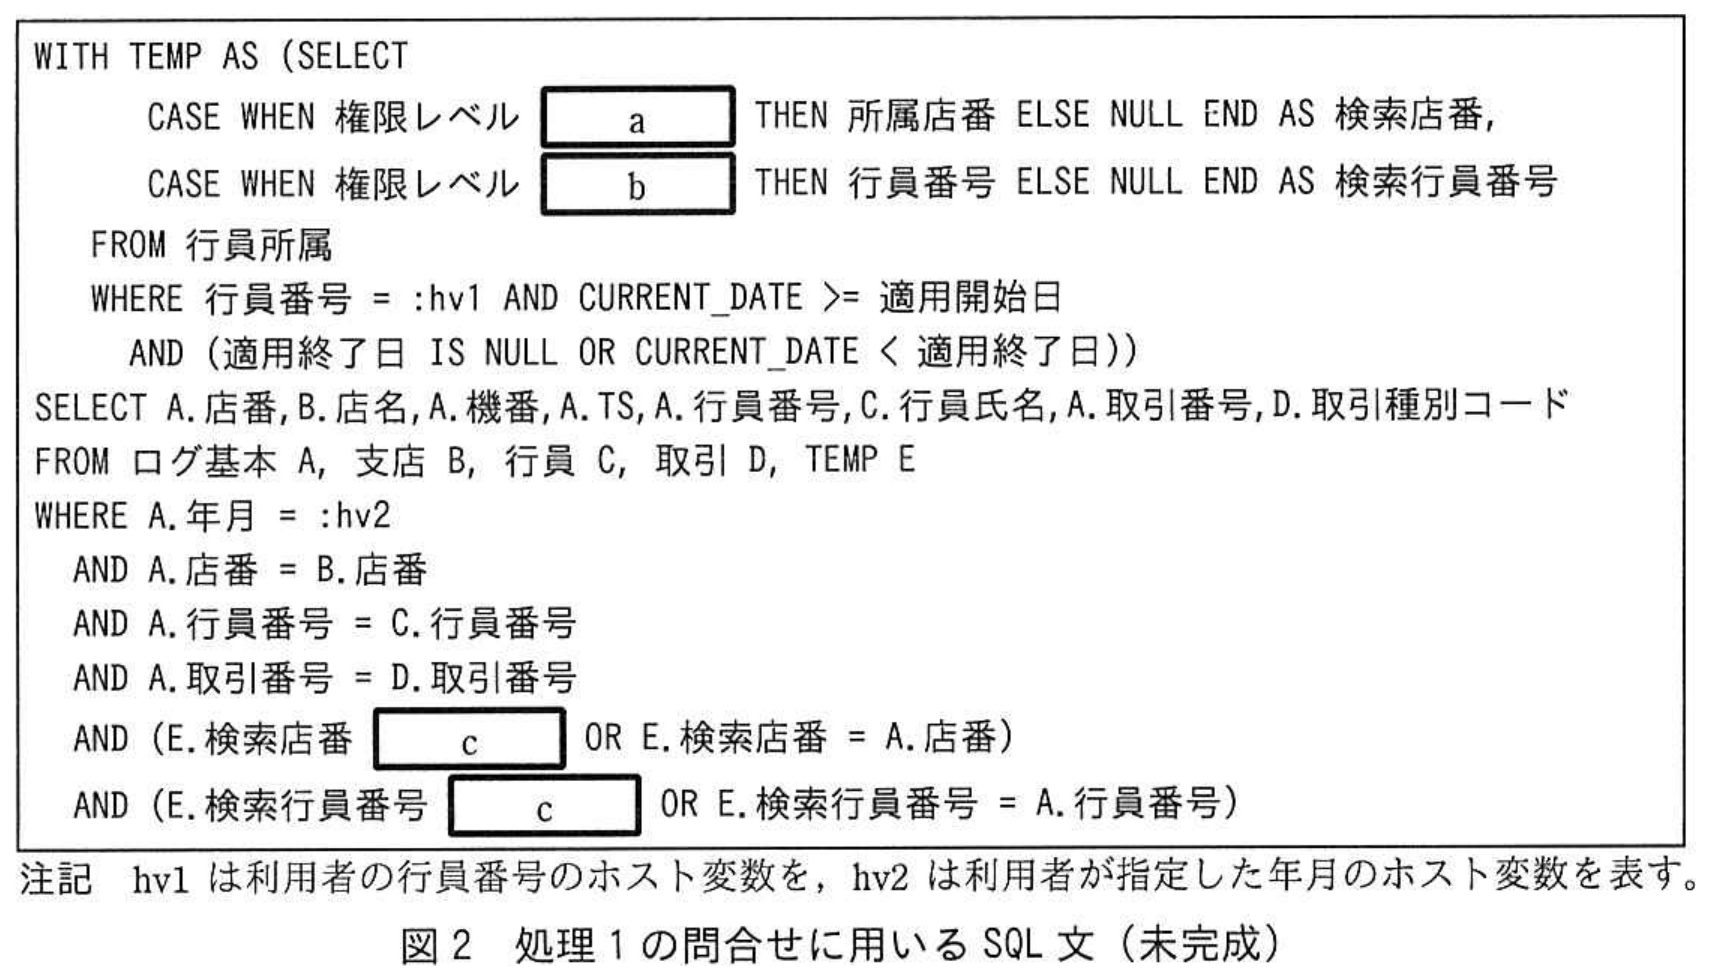
| 処理1 | 利用者が指定した年月に一致する1か月分のログを対象に,店番,店名,機番,TS,行員番号,行員氏名,取引番号,取引種別コードを出力する。利用者の権限レベル(‘1’,‘2’,‘3’)によって参照可能なログが異なり,‘1’の場合は,当該利用者がその時点で所属する支店かつ当該利用者のログだけを,‘2’の場合は,当該利用者がその時点で所属する支店のログだけを,‘3’の場合は,全ログを対象にする。 |
| 処理2 | 全ログを対象に,店番,機番ごとに,TS順に連続する二つのログの画面番号の組を前画面番号,後画面番号としてログ間の経過時間(ミリ秒単位の整数)の平均値を求め,前画面番号,後画面番号,平均経過時間を,平均経過時間の降順に出力する。同じ画面番号が連続する場合は,後画面番号と前画面番号は同じになる。 |
| 処理3 | 利用者が指定した店番,機番,及びTSの範囲(開始年月〜終了年月)に該当するログのTS,取引番号,取引名を,操作の分岐に従ってツリー形式で表示する。また,利用者がTSを一つ選択すると,店番,機番,TSに対応するログテキストを表示する。 |
| 処理4 | 利用者が指定した一つの店番について,年月が前年4月から前年9月までの6か月分のログを対象に,年月,行員番号,取引種別コードごとに伝票金額を集計して,店番,年月,行員番号,取引種別コード,取引種別名,合計伝票金額の一覧を出力する。 |
| 処理5 | 利用者が指定した前月以前の年月に一致する1か月分のログを対象に,店番,端末種別コードごとに明細件数を集計して,店番,店名,端末種別コード,端末種別名,合計明細件数を出力する。 |
| 処理6 | 利用者が指定した一つの画面番号について,年月が前々年4月から前年3月までの12か月分のログを対象に,店名,取引種別名ごとに,明細件数を集計して,画面番号,タイトル,店名,取引種別名,合計明細件数を出力する。 |
(2) ログ分析システムの利用時間帯は,平日の8:00〜22:00である。毎月の最終営業日の22:00から,翌営業日の8:00までの間に,過去データの削除,再編成などの処理(以下,月末処理という)を行う。
2. ログ分析システムの構成
(1) 窓口端末サーバで稼働中のRDBMSをログ分析システムに利用する。
(2) 分析用データの作成・参照・削除に用いるAP(以下,分析APという)を新たに開発し,窓口端末及び窓口端末サーバ上で稼働させる。
3. ログ分析システムのテーブル
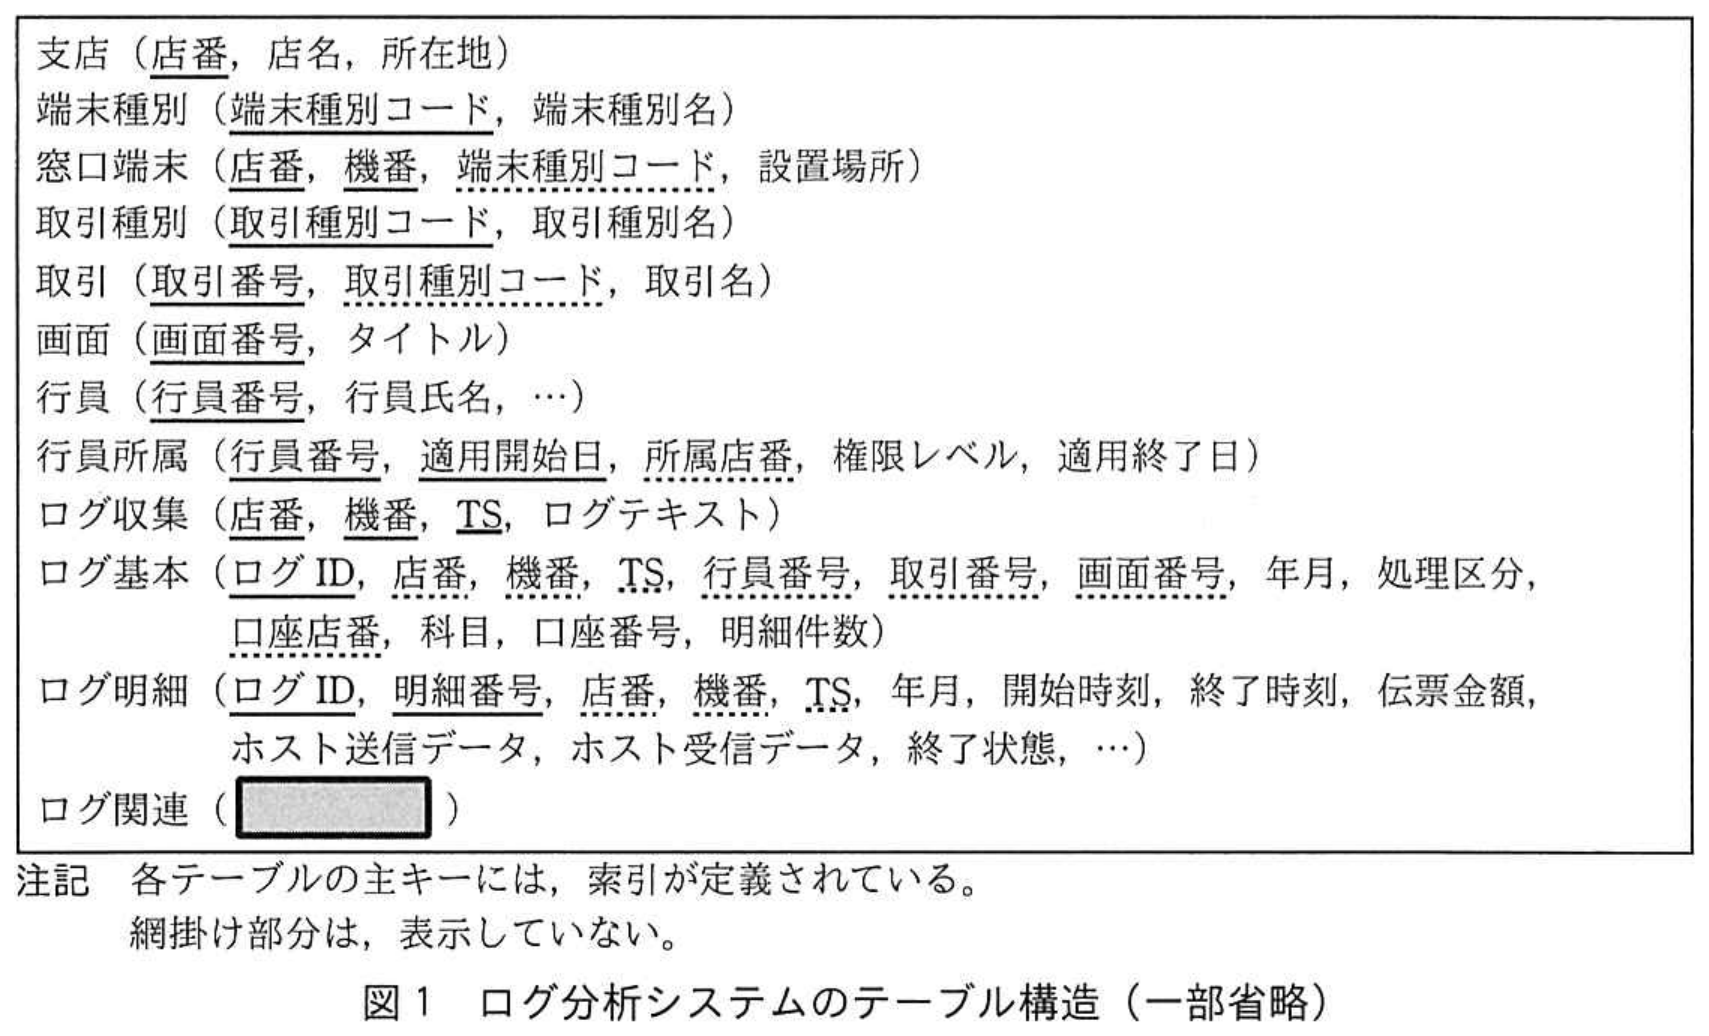
次の方針でデータベースにデータを格納することにし,図1のログ分析システムのテーブル構造,表3の主なテーブルのデータ量見積りを作成した。
(1) 支店から収集したログは,現状どおり“ログ収集”テーブルに格納する。格納処理は,ログファイルごとに,並行して実行する。新たに発生したログを追加するだけで,更新は行わない。
(2) “ログ基本”テーブルには,“ログ収集”テーブルの各行に対応する行を格納し,一意な文字列であるログIDで識別する。検索,集計のキーとなる項目を列として定義し,ログテキストから取り出した値を設定する。年月には,TSの年月を設定する。
(3) ログテキスト内に記録されている複数の操作を,操作ごとに分割して“ログ明細”テーブルに格納する。
(4) 取引の開始から終了までの手続は,複数の操作に分岐していくので,ログは木構造をもつ。分析APによってログを解析し,取引開始ログをルートノードに,その他のログをノードとする木構造の関連を“ログ関連”テーブルに格納する。
(5) マスタ情報(支店,端末種別,窓口端末,取引種別,取引,画面,行員,行員所属)を各テーブルに格納する。マスタ情報は,データ量が少なく,更新は月1回なので,月末処理で変更を反映する。
(6) “ログ収集”,“ログ基本”,“ログ明細”,“ログ関連”テーブルは,月末処理において,TSが翌月の60か月前の月以前の行を削除して,59か月分のログが保存された状態にする。月が変わった後のログを合わせて60か月分を保有する。
 拡大
表3 主なテーブルのデータ量見積り
| テーブル名 | 見積行数 | ページ長(バイト) | 平均行長(バイト) | ページ数 |
| :--- | :--- | :--- | :--- | :--- |
| ログ収集 | 540M | 4,000 | 900 | 135M |
| ログ基本 | 540M | 4,000 | 400 | 60M |
| ログ明細 | 1,620M | 4,000 | 200 | 90M |
注記 表中の単位Mは100万を表す。
〔RDBMSの主な仕様〕
ログ分析システムに利用するRDBMSの主な仕様は次のとおりである。
1. ページ
RDBMSとストレージ間の入出力単位をページという。同じページに異なるテーブルの行が格納されることはない。
2. オプティマイザの仕様
(1) LIKE述語の検索パターンが‘ABC%’のように前方一致の場合は索引探索を選択し,‘%ABC%’,‘%ABC’のように部分一致,後方一致の場合は表探索を選択する。
(2) WHERE句の述語が関数を含む場合,表探索を選択する。
3. 再帰的な問合せの構文のサポート
WITH句にRECURSIVEを指定した再帰的な問合せの構文をサポートする。再帰的な問合せの構文を用いると,例えば,階層構造の組織について,ある組織を起点として上位又は下位の組織を,階層に沿って連続的に検索することができる。
4. ウィンドウ関数のサポート
ウィンドウ関数をサポートする。例えば,選択する行ごとに,その直前の行の列値を参照したい場合には,LAG関数が使用できる。
5. テーブルの物理分割
(1) テーブルごとに一つ又は複数の列を区分キーとし,区分キーの値に基づいて物理的な格納領域を分ける。これを物理分割という。
(2) 区分方法には,ハッシュとレンジの二つがある。ハッシュは,区分キー値を基にRDBMS内部で生成するハッシュ値によって,一定数の区分に行を分配する方法である。レンジは,区分キー値によって決められる区分に行を分配する方法で,分配する条件を,値の範囲又は値のリストで指定する。
(3) 物理分割されたテーブルには,区分キーの値に基づいて分割された索引(以下,ローカル索引という)を定義できる。ローカル索引のキー列には,区分キーを構成する列(以下,区分キー列という)が全て含まれていなければならない。
(4) テーブルを検索するSQL文のWHERE句の述語に区分キー列を指定すると,区分キー列で特定した区分だけを探索する。また,WHERE句の述語に,ローカル索引の先頭列を指定すると,ローカル索引によって区分内を探索することができる。
(5) 問合せの実行時に,一つのテーブルの複数の区分を並行して同時に探索する。同一サーバ上では,問合せごとの同時並行探索数の上限は20である。
(6) 指定した区分を削除するコマンドがある。区分内の格納行数が多い場合,コマンドによる区分の削除は,DELETE文よりも高速である。
6. クラスタ構成のサポート
(1) シェアードナッシング方式のクラスタ構成をサポートする。クラスタは複数のノードで構成され,各ノードには,当該ノードだけがアクセス可能なディスク装置をもつ。
(2) 各ノードへのデータの配置方法には,次に示す分散と複製があり,テーブルごとにいずれかを指定する。
・分散による配置方法は,一つ又は複数の列を分散キーとして指定し,分散キーの値に基づいてRDBMS内部で生成するハッシュ値によって各ノードにデータを分散する。分散キーに指定する列は,主キーを構成する全て又は一部の列である必要がある。
・複製による配置方法は,全ノードにテーブルの複製を保持する。
(3) データベースへの要求は,いずれか一つのノードで受け付ける。要求を受け付けたノードは,要求を解析し,自ノードに配置されているデータへの処理は自ノードで処理を行う。自ノードに配置されていないデータへの処理は,当該データが配置されている他ノードに処理を依頼し,結果を受け取る。特に,テーブル間の結合では,他ノードに処理を依頼するので,自ノード内で処理する場合と比べて,ノード間通信のオーバーヘッドが発生する。
〔問合せの検討〕
1. 問合せの傾向分析・索引設計
表2の処理1〜6の参照テーブルを表4にまとめて,問合せの傾向を分析した。また,図1中のマスタ情報を格納するテーブルについて,処理1〜6で結合に用いられる主キー以外の列に索引を定義することにし,その対象テーブル名・列名を表5にまとめた。
表4 処理1〜6の参照テーブル(未完成)
| 処理名 | 支店 | 端末種別 | 窓口端末 | 取引種別 | 取引 | 画面 | 行員 | 行員所属 | ログ収集 | ログ基本 | ログ明細 | ログ関連 |
| :--- | :---: | :---: | :---: | :---: | :---: | :---: | :---: | :---: | :---: | :---: | :---: | :---: |
| 処理1 | ○ | | | | ○ | | ○ | ○ | | ○ | | |
| 処理2 | | | | | | | | | | ○ | | |
| 処理3 | | | | | ○ | | | | ○ | ○ | | ○ |
| 処理4 | | | | ○ | ○ | | | | | ○ | ○ | |
| 処理5 | | | | | | | | | | ○ | | |
| 処理6 | | | | | | | | | | ○ | | |
注記 ○:テーブルが処理で参照されることを表す。
表5 主キー以外の索引定義対象テーブル名・列名(未完成)
| テーブル名 | 索引を定義する列名 |
| :--- | :--- |
| | |
| | |
2. 処理1の問合せ検討
表2の処理1の問合せに用いる図2のSQL文を作成した。
 拡大
3. 処理2の問合せ検討
表2の処理2の問合せに用いるSQL文の例を,図3〜5に作成した。ここで,GET_LAPSE(TS1, TS2)は,TS1からTS2までの経過時間を,ミリ秒単位の整数で返却するユーザ定義関数である。また,図5中の ア は,図3,4のSQL文と同じ結果を返すように,“ログ基本”テーブルに追加した列の列名である。
なお,図3〜5の結果行には,分析対象でない前画面番号と後画面番号の組が含まれるが,これらは,分析AP上で別途除外されるものとする。
```sql
-- 図3 処理2の問合せに用いるSQL文の例1(未完成)
SELECT B.画面番号 AS 前画面番号, A.画面番号 AS 後画面番号,
AVG(GET_LAPSE(B.TS, A.TS)) AS 平均経過時間
FROM ログ基本 A
LEFT JOIN ログ基本 B ON A.店番 = B.店番 AND A.機番 = B.機番
AND B.TS = (SELECT MAX(Z.TS) FROM ログ基本 Z
WHERE A.店番 = Z.店番 AND A.機番 = Z.機番 AND Z.TS < A.TS)
WHERE B.画面番号 IS NOT NULL
GROUP BY B.画面番号, A.画面番号
d
```
```sql
-- 図4 処理2の問合せに用いるSQL文の例2(未完成)
SELECT 前画面番号, 後画面番号, AVG(経過時間) AS 平均経過時間 FROM
(SELECT LAG(画面番号) OVER (PARTITION BY 店番, 機番 ORDER BY TS) AS 前画面番号,
画面番号 AS 後画面番号,
GET_LAPSE(LAG(TS) OVER (PARTITION BY 店番, 機番 ORDER BY TS), TS) AS 経過時間
FROM ログ基本) TEMP
WHERE 前画面番号 IS NOT NULL
GROUP BY 後画面番号, 前画面番号
d
```
```sql
-- 図5 処理2の問合せに用いるSQL文の例3(未完成)
SELECT B.画面番号 AS 前画面番号, A.画面番号 AS 後画面番号,
AVG(GET_LAPSE(B.TS, A.TS)) AS 平均経過時間
FROM ログ基本 A
LEFT JOIN ログ基本 B ON A.店番 = B.店番 AND A.機番 = B.機番
AND (A.ア - 1) = B.ア
WHERE B.画面番号 IS NOT NULL
GROUP BY A.画面番号, B.画面番号
d
```
〔“ログ関連”テーブルの検討〕
1. テーブル構造の案
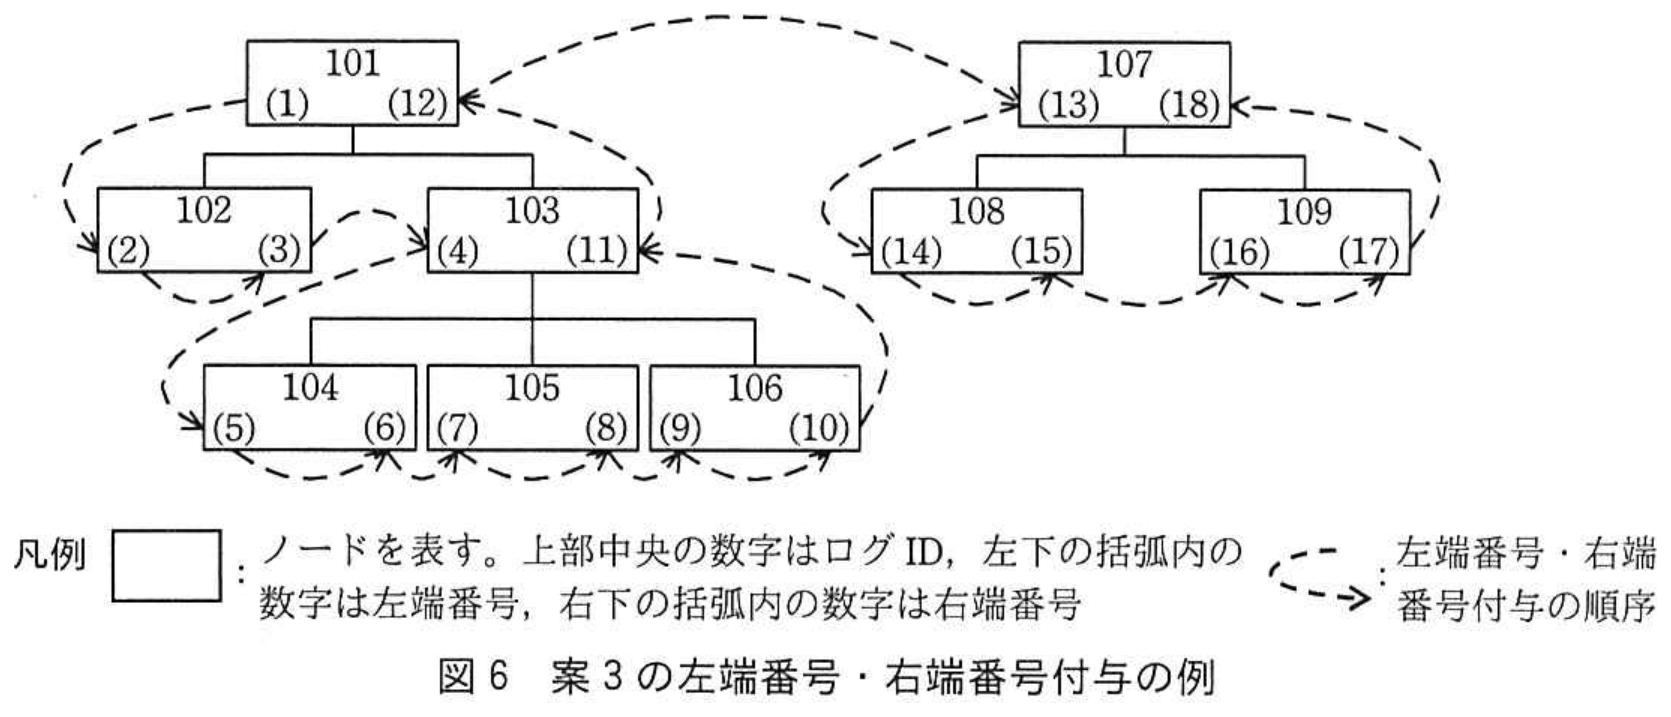
木構造をもつデータを取り扱う場合,テーブル構造によって,行の追加・削除の効率,問合せに用いるSQLの構文,問合せの性能,データの制限が異なる。そこで,表6の“ログ関連”テーブルのテーブル構造案1〜3を検討することにした。検討に当たって,木構造をもつログの例を用いて案を比較することにし,各案におけるテーブルの行を表7〜9に,案3の左端番号・右端番号付与の例を図6にまとめた。
表6 “ログ関連”テーブルのテーブル構造案
| 案 | テーブル構造 | 説明 |
| :--- | :--- | :--- |
| 案1 | ログ関連(ログID, 親ログID) | 各ノードの上位ノードのログIDを,親ログIDに設定する。ルートノードの親ログIDはNULLにする。親ログIDには,索引を定義する。 |
| 案2 | ログ関連(ログID, 経路) | ルートノードから各ノードに至る全ノードのログIDを,接続文字(“/”)で連結した文字列値を経路に設定する。経路には,索引を定義する。 |
| 案3 | ログ関連(ログID, 左端番号, 右端番号) | 左端番号及び右端番号は,両方を合わせて連続する一意な番号であり,あるノードの左端番号と右端番号は,その下位の全ノードに対して,“上位ノードの左端番号 < 下位ノードの左端番号”かつ“下位ノードの右端番号 < 上位ノードの右端番号”となるように設定する。左端番号,右端番号にはそれぞれ索引を定義する。 |
表7 案1の行
| ログID | 親ログID |
| :--- | :--- |
| 101 | NULL |
| 102 | 101 |
| 103 | 101 |
| 104 | 103 |
| 105 | 103 |
| 106 | 103 |
| 107 | NULL |
| 108 | 107 |
| 109 | 107 |
表8 案2の行
| ログID | 経路 |
| :--- | :--- |
| 101 | 101 |
| 102 | 101/102 |
| 103 | 101/103 |
| 104 | 101/103/104 |
| 105 | 101/103/105 |
| 106 | 101/103/106 |
| 107 | 107 |
| 108 | 107/108 |
| 109 | 107/109 |
表9 案3の行
| ログID | 左端番号 | 右端番号 |
| :--- | :--- | :--- |
| 101 | 1 | 12 |
| 102 | 2 | 3 |
| 103 | 4 | 11 |
| 104 | 5 | 6 |
| 105 | 7 | 8 |
| 106 | 9 | 10 |
| 107 | 13 | 18 |
| 108 | 14 | 15 |
| 109 | 16 | 17 |
 拡大
2. テーブル構造案の検討
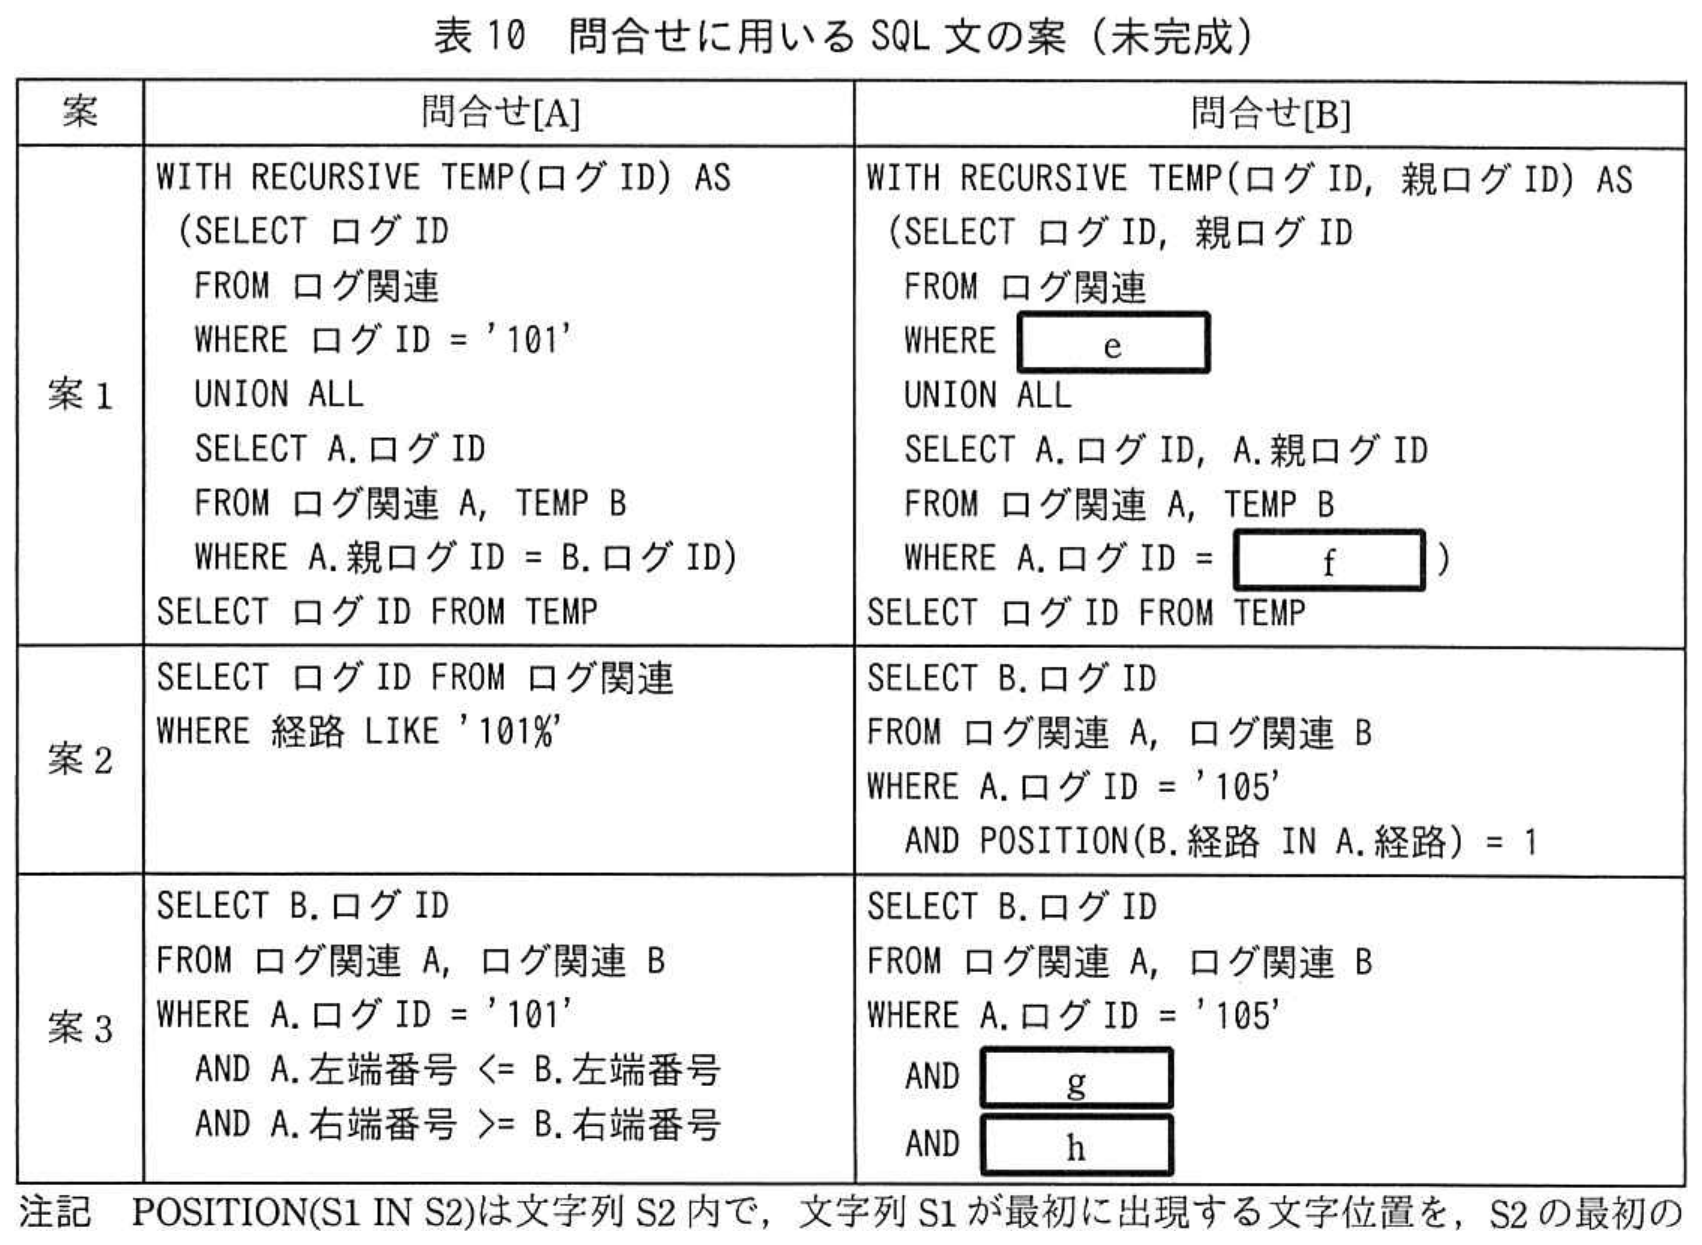
表6の案ごとに,次の問合せA,Bに用いるSQL文の案を,表10にまとめた。
・問合せA ログID=‘101’及びその下位の全てのログIDを抽出する。
・問合せB ログID=‘105’及びその上位の全てのログIDを抽出する。
 拡大
3. テーブル構造案の評価
行の追加・削除の効率の観点では,例えば,ログID=‘199’の新たなログを‘101’の下位,‘103’の上位に追加し,‘103’の階層の深さが一つ下がる場合,‘199’の行追加以外の更新行数は,案1では1行,案2では i 行,案3では j 行である。案 k の負荷が最も高いが,本業務では, l ので,変更時の負荷は問題にならない。
問合せの難易度の観点では,処理3の問合せにSQL文を用いる場合,案1では, m の構文を用いるが,案2,3では,選択,射影, n の関係演算を行う構文を用いればよい。案2と案3の問合せの性能を比較すると,RDBMSのオプティマイザの仕様から,表10の問合せAではほぼ同等であるが,問合せBでは案2が劣る。
これらの評価から,案3による実装が最適と判断されるが,左端番号,右端番号の列を整数型で定義する場合,整数型の上限を超えないように留意する必要がある。
〔テーブルの物理分割・クラスタ構成の検討〕
ログデータを格納するテーブルは,格納行数が多いので,データの追加,参照,削除の性能が懸念される。そこで,テーブルの物理分割を行うことにした。
1. “ログ収集”テーブルの物理分割
表11の“ログ収集”テーブルの物理分割案A〜Cを作成し,性能評価を行った。各案の性能を相対的に評価し,性能が低い案から順に0,1,2の点を付ける。評価が同じ案は,同じ点数とする。
表11 “ログ収集”テーブルの物理分割案・性能評価
| 案 | 区分方法(区分キー) 区分への分割方法 | ローカル索引 | 追加 | 参照 | 削除 |
| :--- | :--- | :--- | :---: | :---: | :---: |
| 案A | ハッシュ(店番,機番,TS) ハッシュ値ごとに60区分に分割 | {店番,機番,TS} | 1 | 0 | 0 |
| 案B | レンジ(店番) 店番ごとに60区分に分割 | {店番,機番,TS} | 1 | 0 | 0 |
| 案C | レンジ(TS) TSの年月ごとに60区分に分割 | {TS,店番,機番} | 0 | 0 | 1 |
注記 {}内は,索引の列を定義順に記述したリストである。
2. “ログ基本”テーブルの物理分割
(1) 物理分割案とその評価
“ログ収集”テーブルと同様に,表12の“ログ基本”テーブルの物理分割案D〜Fを作成し,性能評価を行った。追加,削除の性能評価は“ログ収集”テーブルと同様であったが,参照の性能評価は処理によって異なるので,更に処理ごとに性能評価を行うことにした。
表12 “ログ基本”テーブルの物理分割案・性能評価
| 案 | 区分方法(区分キー) 区分への分割方法 | ローカル索引 | 追加 | 参照 | 削除 |
| :--- | :--- | :--- | :---: | :---: | :---: |
| 案D | ハッシュ(ログID) ハッシュ値ごとに60区分に分割 | {ログID}
{店番,機番,年月,ログID} | 1 | | 0 | | 案E | レンジ(店番) 店番ごとに60区分に分割 | {店番,ログID} | 1 | | 0 | | 案F | レンジ(年月) 年月ごとに60区分に分割 | {年月,ログID} | 0 | | 1 | 注記 {}内は,索引の列を定義順に記述したリストである。 網掛け部分は表示していない。 (2) 探索対象ページ数試算による性能評価 表2の処理4〜6における物理分割案D〜Fについて,次の①〜④を前提条件として,探索対象の最大区分数(以下,探索区分数という),テーブルからの読込みページ数(以下,探索ページ数という)を試算し,表13を作成した。 ① “ログ基本”テーブルへのアクセスだけを対象とする。どの処理でも,検索条件に合致する行は,30,000行あるものとする。 ② 月末営業日の処理を想定し,60か月分のログが全て蓄積されていて,ログは各支店,各年月に均一に分布しているものとする。 ③ どの区分方法でも,ページ総数は同じで,どのページにも最大行数のデータが格納され,ページは各区分に均等に配置されているものとする。また,テーブルの行が複数ページに分割されて格納されることはないものとする。 ④ バッファヒット率は,索引のページでは100%,テーブルのページでは0%とする。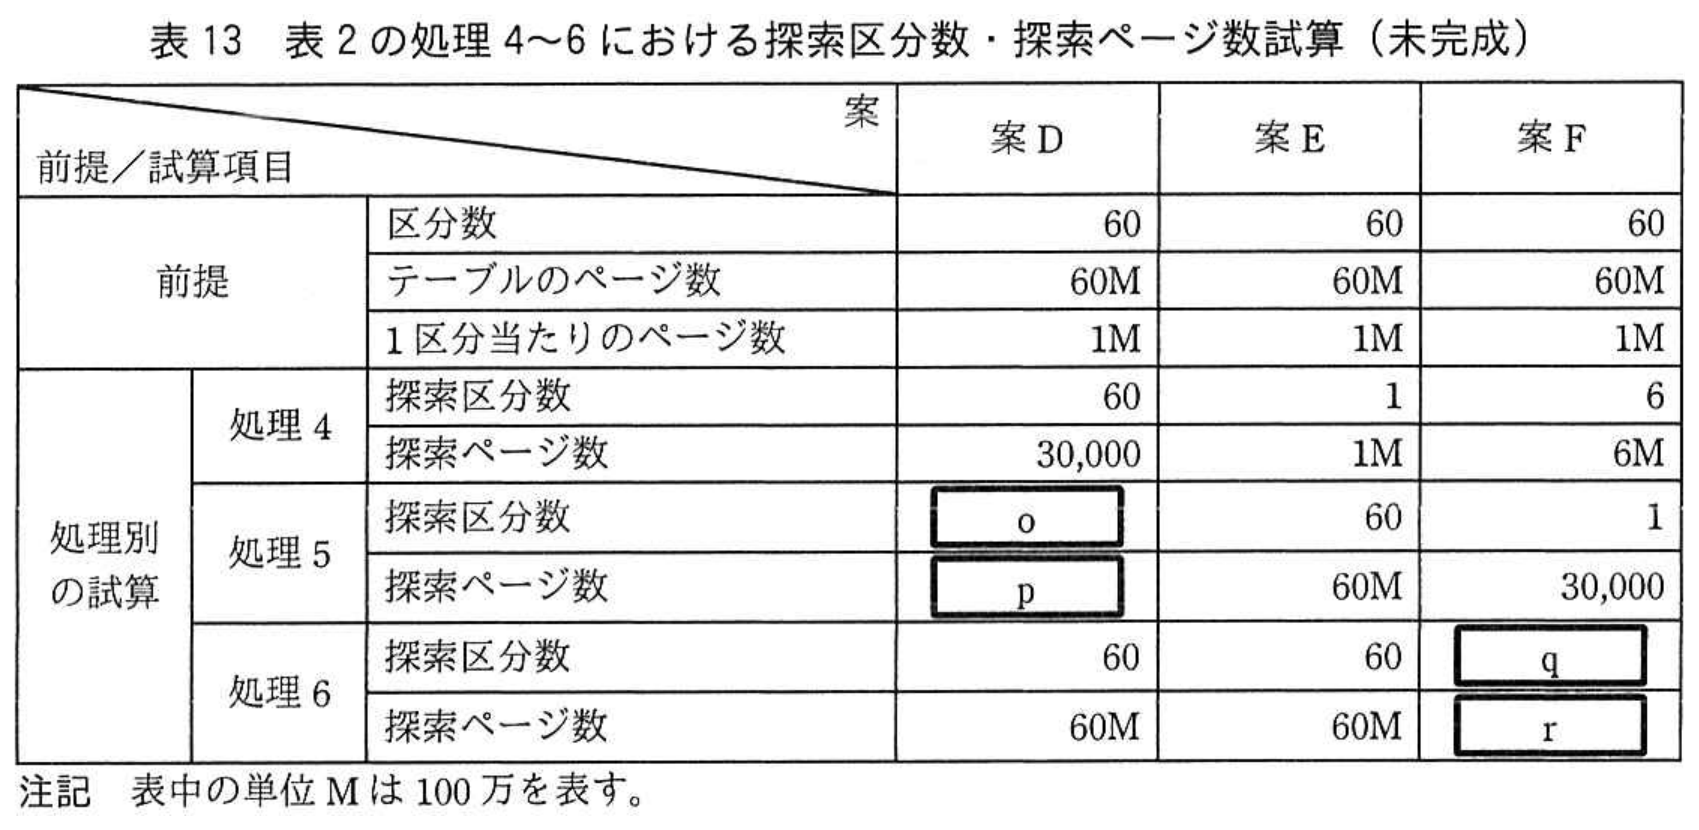 拡大
3. クラスタ構成の検討
テーブルの物理分割だけでは,将来的なデータ量の増加に対応できないので,RDBMSがサポートしているクラスタ構成の検討を行った。クラスタ構成への変更に当たり,各テーブルのデータの配置方法に分散を指定し,主キー列を分散キーとして設定することにした。
クラスタ構成への変更後,表2の処理2,4の性能を試算したところ,処理2は同時並行探索数の上限がなくなることで性能が改善されたが,処理4は性能が低下することが判明した。そこで,処理4の性能低下への対策として,“取引種別”テーブル,“取引”テーブル及び“ログ明細”テーブルのデータの配置方法を見直すことにした。
拡大図1 ログ分析システムのテーブル構造(一部省略)
拡大図2 処理1の問合せに用いるSQL文(未完成)
拡大図6 案3の左端番号・右端番号付与の例
拡大表10 問合せに用いるSQL文の案(未完成)
{店番,機番,年月,ログID} | 1 | | 0 | | 案E | レンジ(店番) 店番ごとに60区分に分割 | {店番,ログID} | 1 | | 0 | | 案F | レンジ(年月) 年月ごとに60区分に分割 | {年月,ログID} | 0 | | 1 | 注記 {}内は,索引の列を定義順に記述したリストである。 網掛け部分は表示していない。 (2) 探索対象ページ数試算による性能評価 表2の処理4〜6における物理分割案D〜Fについて,次の①〜④を前提条件として,探索対象の最大区分数(以下,探索区分数という),テーブルからの読込みページ数(以下,探索ページ数という)を試算し,表13を作成した。 ① “ログ基本”テーブルへのアクセスだけを対象とする。どの処理でも,検索条件に合致する行は,30,000行あるものとする。 ② 月末営業日の処理を想定し,60か月分のログが全て蓄積されていて,ログは各支店,各年月に均一に分布しているものとする。 ③ どの区分方法でも,ページ総数は同じで,どのページにも最大行数のデータが格納され,ページは各区分に均等に配置されているものとする。また,テーブルの行が複数ページに分割されて格納されることはないものとする。 ④ バッファヒット率は,索引のページでは100%,テーブルのページでは0%とする。
拡大表13 表2の処理4〜6における探索区分数・探索ページ数試算(未完成)
設問一覧 & 解答・演習
まずは解答を作成してみましょう。「解答例を見る」をクリックするとIPA公式解答例と採点基準が開きます。
設問1 (1)記号・選択式
表4中の太枠内に“○”印を記入し,表を完成させよ。
※直接入力してください
設問1 (2)記号・選択式
表5中の空欄を埋め,表を完成させよ。
※直接入力してください
設問1 (3)記号・選択式
図2中の a 〜 c に入れる適切な字句を答えよ。また,図3〜5中の d に入れる適切な字句を答えよ。
※直接入力してください
設問1 (4)記述問題
制限字数:20 字以内
図5中の ア の列に事前に設定すべき値の内容を,20字以内で具体的に述べよ。
0 / 20 文字
設問2 (1)記号・選択式
表10中の e 〜 h に入れる適切な字句を答えよ。
※直接入力してください
設問2 (2)記号・選択式
“3. テーブル構造案の評価”の本文中の i 〜 k に入れる適切な数字を答えよ。また,l 〜 n に入れる適切な字句を,本文中の用語を用いて答えよ。
※直接入力してください
設問2 (3)記述問題
制限字数:30 字以内
“3. テーブル構造案の評価”の本文中の下線部について,問合せBでは,案2の性能が案3よりも劣る理由を,30字以内で具体的に述べよ。
0 / 30 文字
設問3 (1)記述問題
制限字数:30 字以内
表11中の性能評価について,次の①,②をそれぞれ30字以内で具体的に述べよ。
① 追加の性能評価において,案Cが低い理由
② 参照の性能評価において,どの案も同じ理由
① 追加の性能評価において,案Cが低い理由
② 参照の性能評価において,どの案も同じ理由
0 / 30 文字
設問3 (2)記号・選択式
表13中の o 〜 r に入れる適切な数値を答えよ。また,案Eについて,処理4,5の探索ページ数の試算値が最小となるローカル索引を構成する列名を全て答えよ。
※直接入力してください
設問3 (3)記述問題
制限字数:50 字以内
“3. クラスタ構成の検討”について,①〜③に答えよ。
① 処理4の性能が低下した理由を,50字以内で具体的に述べよ。
② “取引種別”テーブル及び“取引”テーブルについて行うべき対応を,20字以内で具体的に述べよ。
③ “ログ明細”テーブルの分散キーを見直すことにした。どのように見直せばよいか,20字以内で具体的に述べよ。
① 処理4の性能が低下した理由を,50字以内で具体的に述べよ。
② “取引種別”テーブル及び“取引”テーブルについて行うべき対応を,20字以内で具体的に述べよ。
③ “ログ明細”テーブルの分散キーを見直すことにした。どのように見直せばよいか,20字以内で具体的に述べよ。
0 / 50 文字
午後II長文記述の得点力を引き上げる定番対策書Amazon・楽天 公式提携
PR

IPA 厳選対策書徹底攻略 データベーススペシャリスト教科書 令和8年度株式会社わくわくスタディワールド 瀬戸 美月 著 / インプレス
DB徹底攻略株式会社わくわくスタディワールド 瀬戸 美月 著 / インプレス
徹底攻略 データベーススペシャリスト教科書 令和8年度
💡 推薦ポイント:午後I・午後IIの概念データモデル穴埋めや排他制御・性能設計の記述問題で確実に合格点を勝ち取る実践テクニックが満載です。
¥3,278(税込)
※本リンク先はプロモーション(アフィリエイト広告)が含まれています
【出題趣旨】IPA公式発表
【採点講評】IPA公式発表
本問に関連するデータベーススペシャリスト重要用語解説
本番形式・制限時間付きで演習する
平成31年 春期 午後II(2問中1問選択・120分)を実戦演習モードで通し解答し、総合採点を受けられます。