データベーススペシャリスト午後II 総合事例記述平成28年 春期
午後II 問1
問1 データベースの物理設計とデータ移行に関するデータベース設計・実装
テーマ:データベースの物理設計、データ移行方式の検討およびデータ検証
左右2分割表示:左側の問題文をスクロールしながら右側の設問に解答できます
長文事例本文
図表クリックで拡大問1 データベースの物理設計とデータ移行に関する次の記述を読んで,設問1〜3に答えよ。
D銀行は,首都圏の100支店に,投資信託などの運用商品を扱う部課があり,専任の営業員が個人顧客(以下,顧客という)への販売活動を行っている。営業員の販売活動には,顧客の個人情報,資産情報,投資経験,取引などを格納した顧客情報管理システムが利用されている。D銀行では,顧客情報管理システムのDBサーバ及びストレージの老朽化に伴うリプレース(以下,DBサーバ更改という)に当たって,RDBMSのバージョンアップ,アプリケーション(以下,APという)の機能追加などを行うことにした。
〔データベースの論理設計〕
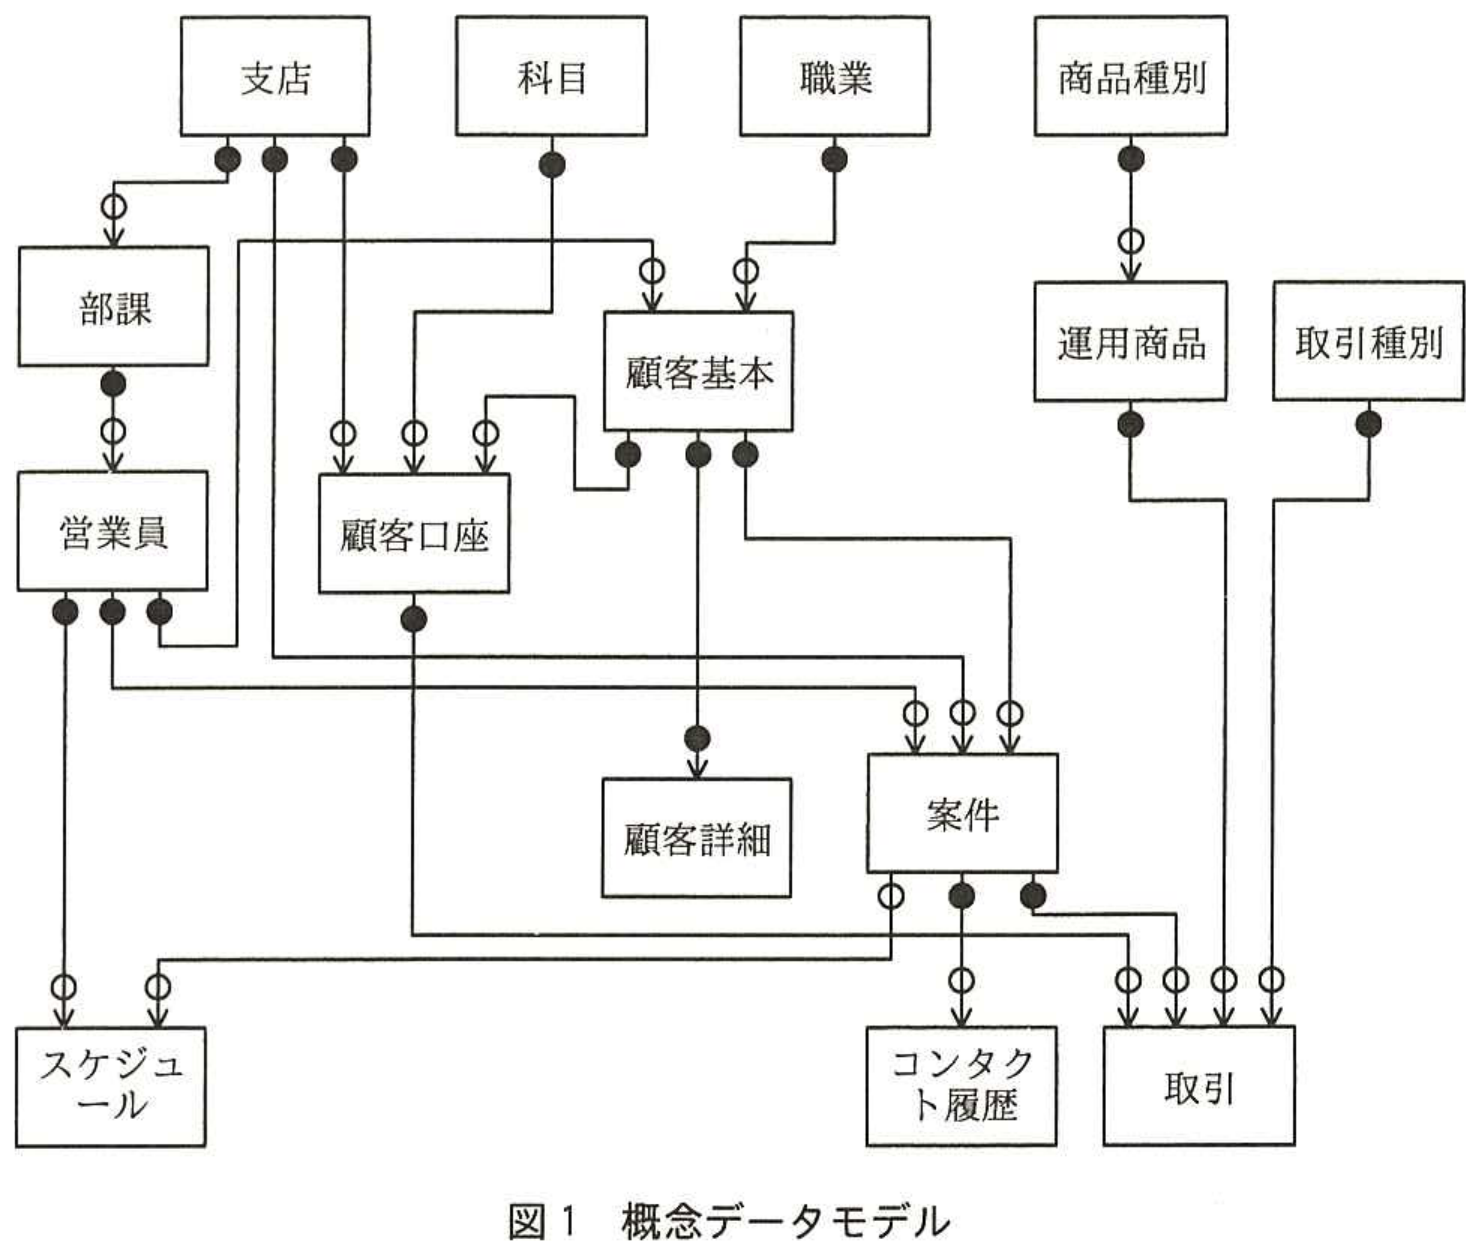
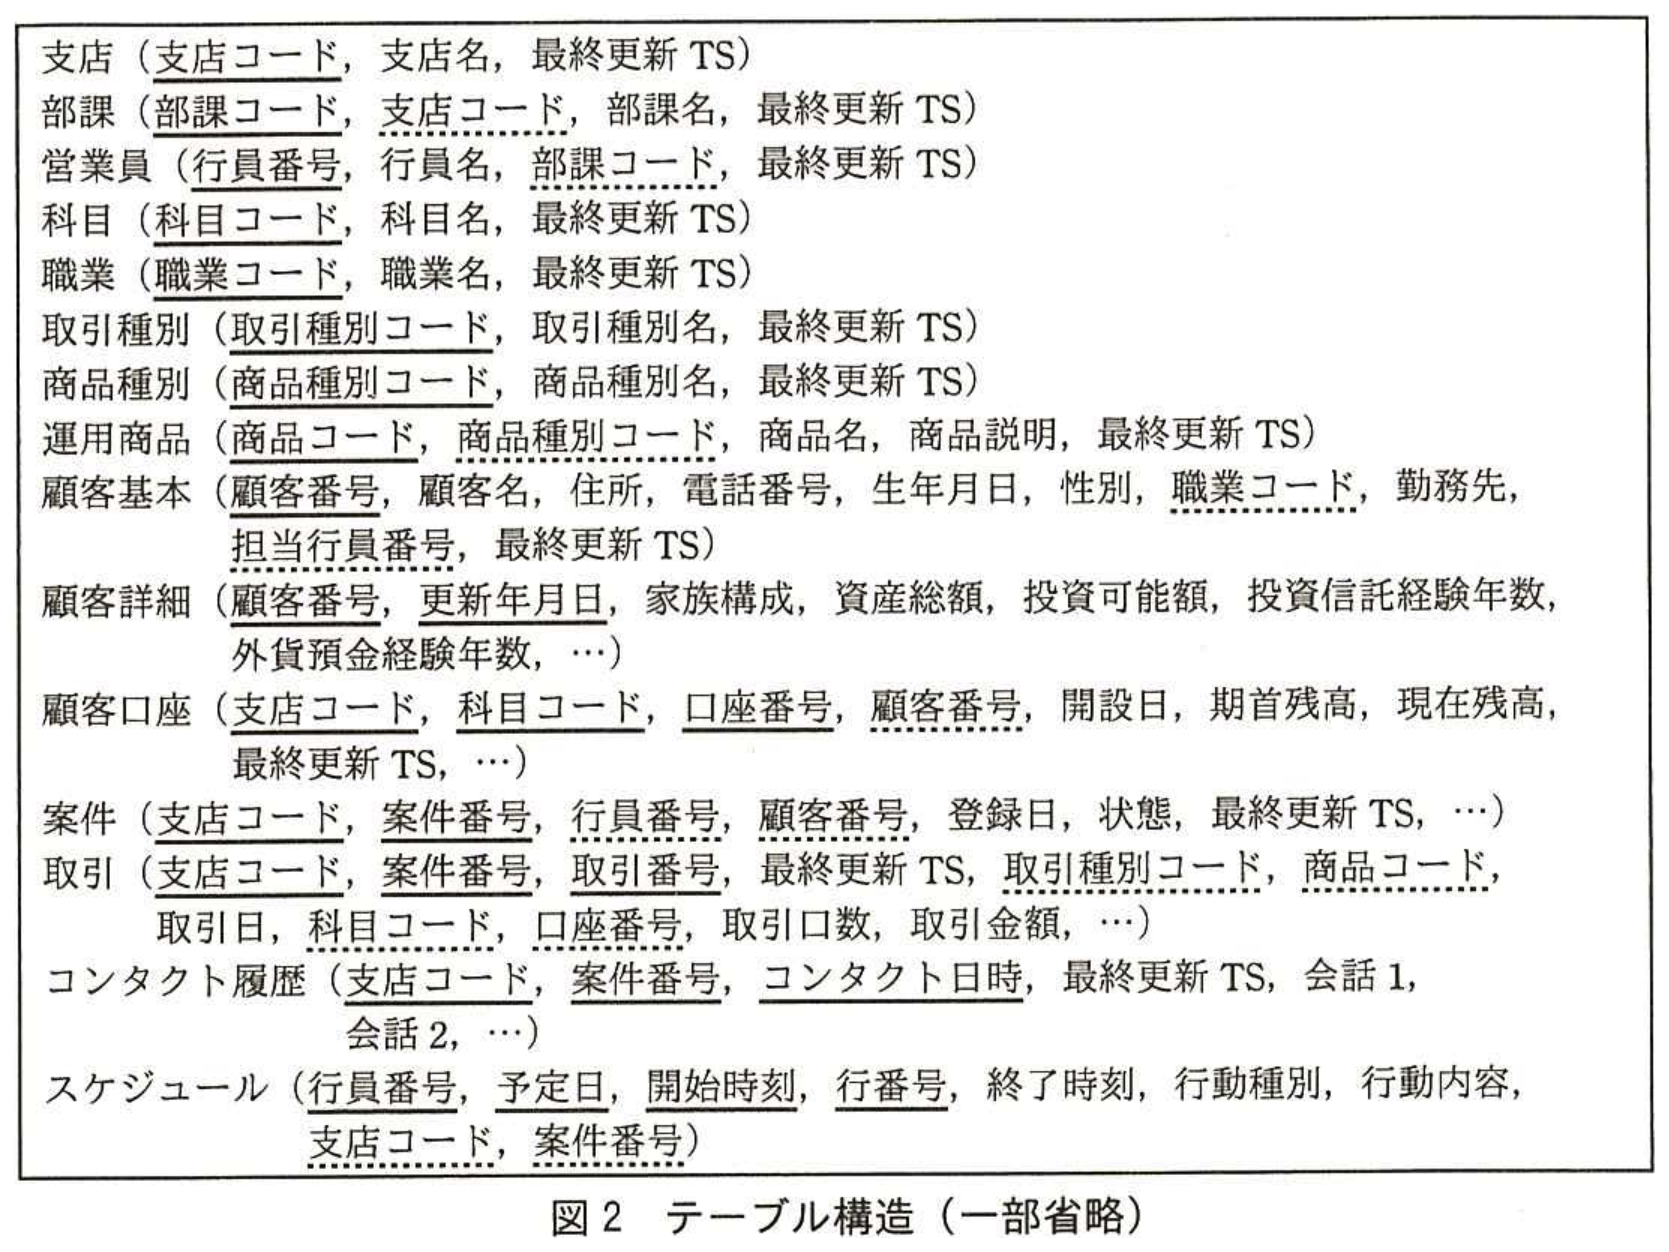
顧客情報管理システムの概念データモデルを図1に,テーブル構造を図2に,主な列とその意味・制約を表1に示す。
 拡大
 拡大
表1 主な列とその意味・制約
| 列名 | 意味・制約 |
| :--- | :--- |
| 支店コード | 支店を一意に識別するコード(4桁の半角英数字) |
| 顧客番号 | 銀行内で顧客を一意に識別する番号(1〜999,999,999) |
| 顧客名 | 顧客の氏名(全角文字30字以内。平均文字数は5文字)。“顧客基本”テーブルの顧客名は,指定した文字列との完全一致,部分一致(あいまい検索)などの条件検索に使用される。 |
| 住所 | 顧客の住所(全角文字30字以内。平均文字数は19文字) |
| 性別 | '0'(未記入),'1'(男性),'2'(女性)のいずれか |
| 行員番号 | 銀行内で役員・行員を一意に識別する番号(1,000,001〜9,999,999) |
| 科目コード | 普通預金,定期預金,投資信託などの種別を識別するコード(3桁の半角英数字) |
| 口座番号 | 顧客の口座を支店コードごと,科目コードごとに一意に識別する番号(7桁の半角英数字) |
| 期首残高,現在残高 | 残高は,顧客の各口座における,ある時点の保有金額である。期首残高は期首日(4月1日)時点の残高,現在残高は最新の残高を表す。 |
| 案件番号 | 支店ごとに案件を一意に識別する番号(1〜99,999,999)。“スケジュール”テーブルの支店コードと案件番号は,案件に関連する顧客との面談予定などを登録する場合にだけ設定する。 |
| 登録日 | 案件を最初に起案した年月日。“案件”テーブルの場合は必須で,変更することはない。 |
| 予定日 | 会議,顧客往訪などの行動が予定されている年月日 |
| 開始時刻,終了時刻,行番号 | 開始時刻,終了時刻は,スケジュールの開始時分と終了時分。“スケジュール”テーブルの場合は必須で,終了時刻は開始時刻よりも後でなければならない。行番号は,同じ開始時刻で複数の予定を登録できるように,1〜999の連番で区別する。 |
| 行動種別 | '1'(会議),'2'(打合せ),'3'(顧客往訪),'4'(顧客来訪),'5'(作業)のいずれか |
| 行動内容 | 具体的な行動内容(全角文字1,000字以内。平均文字数は58文字)。“スケジュール”テーブルの場合は任意である。 |
| 最終更新TS | テーブルの行が,追加又は最後に更新された時刻印(年月日時分秒)。システムで自動設定する。 |
〔顧客情報管理システムの現状とDBサーバ更改〕
1. 現状
(1) 顧客情報管理システムは,Webサーバ,APサーバ,DBサーバから成るシステムで,内部ネットワーク上に設置されている。内部ネットワークは,外部ネットワークから隔離されているので,外部から侵入されることはない。
(2) 案件,取引,コンタクト履歴には,案件の登録日が10年前の月初めから現在までの全てのデータが保存されている。コンタクト履歴は,過去のデータが更新されることもある。保存期間が過ぎた案件及び案件に関連するデータは,毎月末日のバッチ処理で削除される。
2. DBサーバ更改の方針
(1) 新DBサーバを導入し,現行DBサーバと同じネットワーク上に設置する。
(2) 現行DBサーバのデータを新DBサーバに移行し,新DBのデータ検証後にAPサーバからの接続先を新DBサーバに切り替える。
(3) 本番開始前1か月程度の移行準備期間(以下,準備期間という)には,日々のバッチ処理終了後の6時間だけサービスを停止する。本番開始直前のデータ移行・検証期間(以下,移行期間という)は,連続して2日間サービスを停止する。本番開始後には,1か月程度の特別な監視体制の維持期間(以下,監視期間という)を設ける。
(4) データ移行時には,その月の末日のバッチ処理で削除されることが分かっているデータは,移行の対象としない。また,各テーブルの最終更新TSの列値は,システムで自動設定せず,そのまま移行する。
3. DBサーバ更改時の実施事項
(1) 現行DBサーバで稼働するRDBMSは,上位バージョンに移行する。
(2) 顧客とのアポイントメントを案件と関係付けて管理するために,スケジュール管理機能を追加する。スケジュール管理機能の提供は,DBサーバ更改に合わせて開始する。
(3) 個人情報の漏えい対策を強化する。
(4) 取扱商品の増加に備えて,商品コードの桁数を4桁から6桁に増やす。移行時に,現在の商品コードの前に'00'を付加する。
〔RDBMSの仕様〕
1. 表領域
(1) テーブル,索引などのストレージ上の物理的な格納場所を,表領域という。
(2) RDBMSとストレージ間のデータ入出力単位を,データページという。データページには,テーブル,索引のデータが格納される。表領域ごとに,ページサイズ(1データページの長さ。2,000,4,000,8,000,16,000バイトのいずれかである)と,空き領域率(将来の更新に備えて,データページ内に確保しておく空き領域の割合)を指定する。
(3) 同じデータページに,異なるテーブルの行が格納されることはない。
2. テーブル
(1) テーブルの列には,NOT NULL制約を指定することができる。NOT NULL制約を指定しない列には,NULLかどうかを表す1バイトのフラグが付加される。
(2) 主キー制約には,主キーを構成する列名を指定する。
(3) 参照制約には,列名,参照先テーブル名,参照先列名を指定する。
(4) 検査制約には,同一行の列に対する制約を指定する。
(5) 使用可能なデータ型は,表2のとおりである。
表2 使用可能なデータ型
| データ型 | 説明 |
| :--- | :--- |
| CHAR(n) | n文字の半角固定長文字列(1≦n≦255)。文字列がn字未満の場合は,文字列の後に半角の空白を挿入し,nバイトの領域に格納される。 |
| NCHAR(n) | n文字の全角固定長文字列(1≦n≦127)。文字列がn字未満の場合は,文字列の後に全角の空白を挿入し,“n×2”バイトの領域に格納される。 |
| VARCHAR(n) | 最大n文字の半角可変長文字列(1≦n≦8,000)。“文字列の文字数”バイトの領域に格納され,4バイトの制御情報が付加される。 |
| NCHAR VARYING(n) | 最大n文字の全角可変長文字列(1≦n≦4,000)。“文字列の文字数×2”バイトの領域に格納され,4バイトの制御情報が付加される。 |
| SMALLINT | -32,768〜32,767の範囲内の整数。2バイトの領域に格納される。 |
| INTEGER | -2,147,483,648〜2,147,483,647の範囲内の整数。4バイトの領域に格納される。 |
| DECIMAL(m,n) | 精度m(1≦m≦31),位取りn(0≦n≦m)の10進数。“m÷2+1”の小数部を切り捨てたバイト数の領域に格納される。 |
| DATE | 0001-01-01〜9999-12-31の範囲内の日付。4バイトの領域に格納される。 |
| TIME | 00:00:00〜23:59:59の範囲内の時刻。3バイトの領域に格納される。 |
| TIMESTAMP | 0001-01-01 00:00:00.000000〜9999-12-31 23:59:59.999999の範囲内の時刻印。10バイトの領域に格納される。 |
3. 索引
索引には,ユニーク索引と非ユニーク索引がある。
4. DBの相互接続機能
同じネットワーク上にある異なるDBを,相互接続する機能である。相互接続したDB上のテーブルは,あたかも同じDB上にあるかのように,一つのSQL文で操作することができる。SQL文では,テーブル名をDBの識別子とスキーマ名の両方で修飾することができる。
5. エクスポートツール,インポートツール
テーブルのデータをテキストファイルに出力するエクスポートツールと,テキストファイルのデータをテーブルに入力するインポートツールがある。エクスポートツールでは,SQLのSELECT文を指定することができる。一方,インポートツールでは,SQLのINSERT文と同じ処理が行われる。
〔データベースの物理設計〕
1. テーブル定義
次の方針に基づいて,テーブル定義表を作成し,テーブル定義を行う。
(1) データ型欄には,データ型,データ型の適切な長さ,精度,位取りを記入する。データ型の選択は,次の規則に従う。
① 文字列型の列が全角文字の場合は,NCHAR又はNCHAR VARYINGを選択し,それ以外の場合はCHAR又はVARCHARを選択する。
② 数値の列が整数である場合は,取り得る値の範囲に応じて,SMALLINT又はINTEGERを選択する。それ以外の場合はDECIMALを選択する。
③ ①及び②どちらの場合も,列の取り得る値の範囲に従って,格納領域の長さが最小になるようにデータ型を選択する。
④ 日付,時刻,時刻印の列は,専用のデータ型を選択する。
(2) NOT NULL欄には,NOT NULL制約がある場合はYを,ない場合はNを記入する。
(3) 格納長欄には,RDBMSの仕様に従って,格納長を記入する。可変長文字列の格納長は,表1から平均文字数が分かる場合はそれを基準に算出し,それ以外の場合は最大文字数の半分を基準に算出する。
(4) 索引の種類と構成列欄には,作成する索引を記入する。
① 索引の種類には,P(主キーの索引),U(ユニーク索引),NU(非ユニーク索引)がある。
② 主キーの索引は,必ず作成する。
③ 主キー以外で値が一意となる列又は列の組合せには,必ずユニーク索引を作成する。それ以外の列又は列の組合せが,外部キーを構成する場合は,必ず非ユニーク索引を作成する。
④ 各索引の構成列には,構成列の定義順に1からの連番を記入する。
(5) 制約欄には,参照制約,検査制約をSQLの構文で記入する。
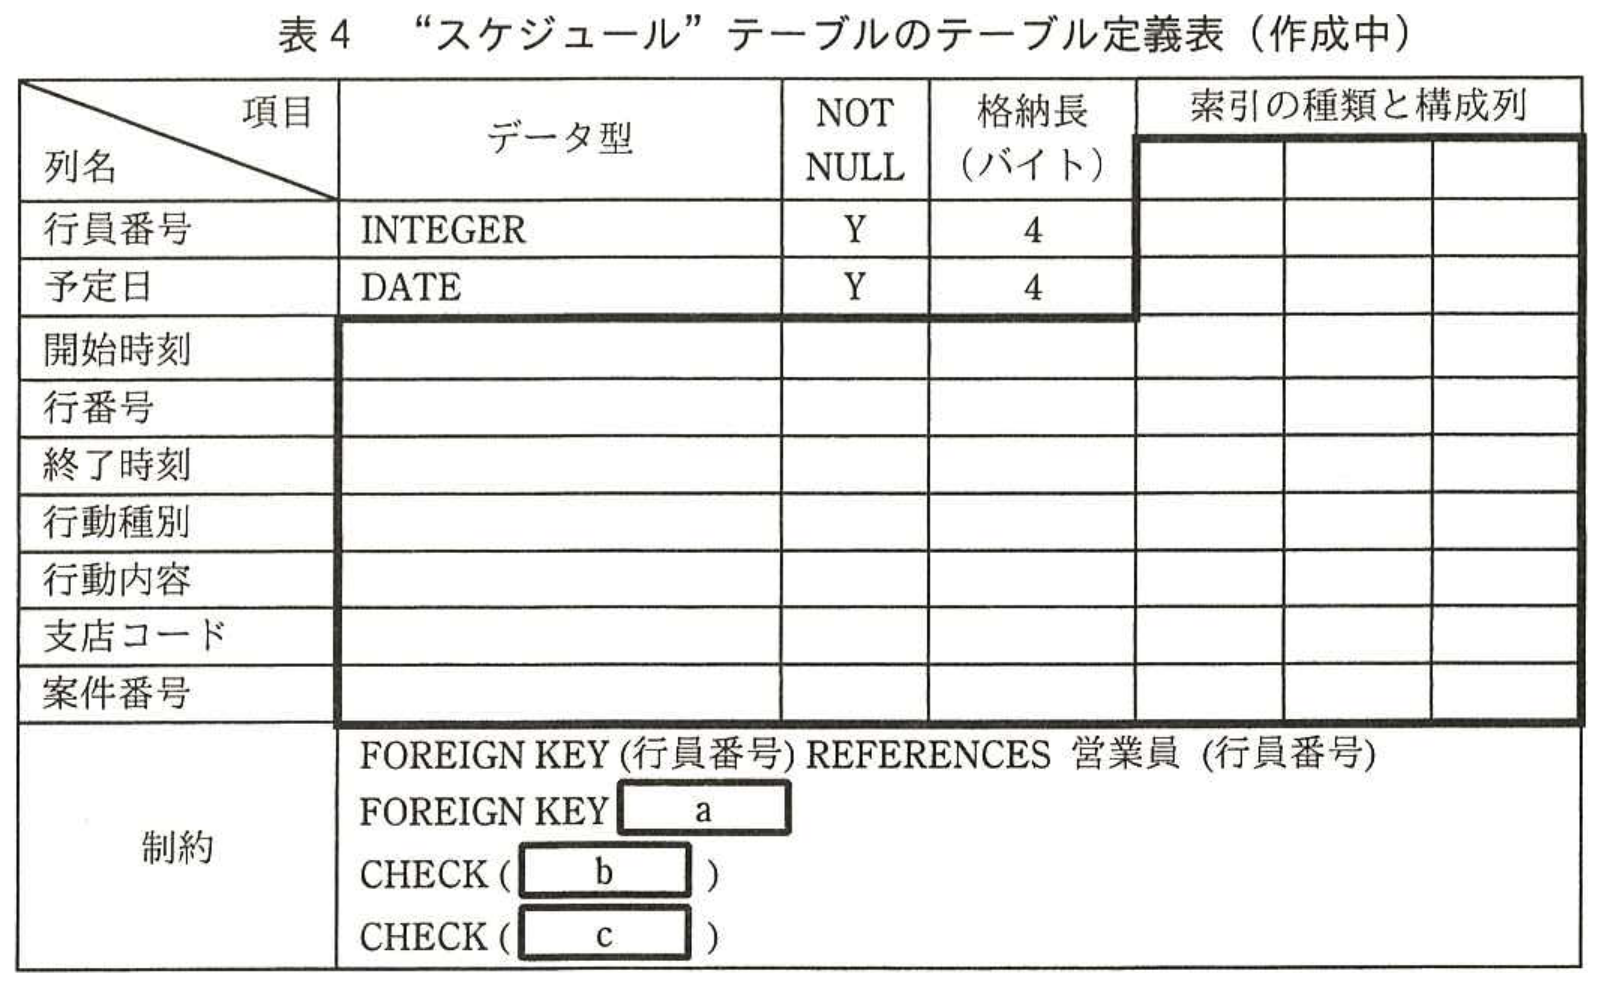
“顧客基本”,“スケジュール”テーブルのテーブル定義表を表3,表4に示す。
表3 “顧客基本”テーブルのテーブル定義表
| 列名 | データ型 | NOT NULL | 格納長(バイト) | 索引の種類と構成列 P | 索引の種類と構成列 NU | 索引の種類と構成列 NU | 索引の種類と構成列 NU |
| :--- | :--- | :--- | :--- | :--- | :--- | :--- | :--- |
| 顧客番号 | INTEGER | Y | 4 | 1 | | | |
| 顧客名 | NCHAR VARYING(30) | Y | 14 | | 1 | | |
| 住所 | NCHAR VARYING(200) | Y | 42 | | | | |
| 電話番号 | VARCHAR(20) | Y | 14 | | | | |
| 生年月日 | DATE | Y | 4 | | | | |
| 性別 | CHAR(1) | Y | 1 | | | | |
| 職業コード | CHAR(4) | Y | 4 | | | 1 | |
| 勤務先 | NCHAR VARYING(100) | N | 105 | | | | |
| 担当行員番号 | INTEGER | N | 5 | | | | 1 |
| 最終更新TS | TIMESTAMP | Y | 10 | | | | |
制約:
FOREIGN KEY (職業コード) REFERENCES 職業 (職業コード)
FOREIGN KEY (担当行員番号) REFERENCES 営業員 (行員番号)
CHECK (性別 IN ('0', '1', '2'))
 拡大
2. データ所要量の見積り
“スケジュール”テーブルのデータ所要量を見積るために,表5を作成した。なお,データ所要量は,項番1〜5の値を用いて算出するものとする。
表5 “スケジュール”テーブルのデータ所要量(未完成)
| 項番 | 項目 | 値 |
| :--- | :--- | :--- |
| 1 | 見積行数 | 1,200,000 行 |
| 2 | ページサイズ | 4,000 バイト |
| 3 | 平均行長 | d バイト |
| 4 | 1データページ当たりの平均行数 | e 行 |
| 5 | 必要データページ数 | f ページ |
| 6 | データ所要量 | g 百万バイト |
3. 個人情報保護の強化
外部ネットワークから隔離されていても,内部の人間の犯行などによる個人情報の漏えいが懸念される。強化策として,次に示す“顧客基本”テーブル実装案を検討し,想定されるセキュリティ事故A〜Cへの対策の有効性を評価して,表6にまとめた。
案:顧客名,住所,電話番号の列値を,次のように格納,検索する。
・APは,RDBMSの暗号化関数によってデータを暗号化し,SQL文によって列に格納する。このとき,各列のデータ型,データ長の定義を変更する。
・APは,SQL文によって暗号化したデータを検索し,RDBMSの復号関数によって復号する。
・暗号化と復号の鍵は,AP内に埋め込み,外部から見えないようにする。
表6 セキュリティ事故と対策の有効性評価(未完成)
| 記号 | セキュリティ事故 | 有効性 |
| :--- | :--- | :--- |
| A | 営業員が顧客情報照会のAPを利用して,複数顧客の顧客名,住所,電話番号を検索して得られたデータを不正に持ち出した。 | h |
| B | 顧客情報管理システムのDBのフルバックアップを格納したメディアが盗難に遭った。 | i |
| C | 顧客情報管理システムのDBへのログインIDとパスワードが盗まれ,APを利用せずに,“顧客基本”テーブルに対するSELECT文が不正に実行された。 | △ |
注記 ○:有効である △:有効でない場合がある ×:有効でない
〔データ移行の前提・移行計画・データ移行処理方式設計〕
1. データ移行の前提
(1) テーブルへのデータ投入順序
テーブルへのデータ投入順序を,表7に示す。表7では,図2の“スケジュール”以外のテーブルを,参照制約違反が発生しない限り,できるだけ小さい枠番号のいずれかに配置し,枠番号順にデータ投入を行う。同じ枠番号内のテーブルへのデータ投入は,並行して行われる。
表7 テーブルへのデータ投入順序(未完成)
| 枠番号 | テーブル名 |
| :--- | :--- |
| 1 | 支店,職業,科目,取引種別,j |
| 2 | 部課,k |
| 3 | 営業員 |
| 4 | l |
| 5 | 案件,m |
| 6 | n |
(2) データ量の調査
現行DBの主なテーブルの統計情報を,表8に示す。
表8 現行DBの主なテーブルの統計情報
| テーブル名 | 平均行長(バイト) | 行数(行) | ページサイズ(バイト) | 使用ページ数(ページ) |
| :--- | :--- | :--- | :--- | :--- |
| 商品種別 | 100 | 60 | 2,000 | 4 |
| 運用商品 | 600 | 1,300 | 4,000 | 217 |
| 顧客基本 | 203 | 5,100,000 | 4,000 | 300,000 |
| 顧客詳細 | 4,000 | 48,000,000 | 16,000 | 16,000,000 |
| 顧客口座 | 240 | 30,000,000 | 4,000 | 2,000,000 |
| 案件 | 1,500 | 72,000,000 | 8,000 | 18,000,000 |
| 取引 | 400 | 216,000,000 | 8,000 | 12,000,000 |
| コンタクト履歴 | 1,200 | 576,000,000 | 8,000 | 96,000,000 |
(3) データ移行方法
現行DBから新DBにデータを移行するには,次に示す二つの方法がある。二つの方法について,それぞれ主なテーブルのデータ移行処理速度を実測し,表9を作成した。
① エクスポート・インポート(E&I)
現行DBのテーブルからデータをエクスポート(EXP)したファイルを新DBサーバに転送し,新DBのテーブルにインポート(IMP)する。EXPとIMPには,それぞれエクスポートツールとインポートツールを用いる。
② ダイレクトインサート(DI)
DBの相互接続機能を利用して,SQL文の実行によって,現行DBのテーブルのデータを読み込み,新DBのテーブルのデータを直接,追加,更新,削除する。
表9 主なテーブルのデータ移行処理速度
| テーブル名 | EXP(行/秒) | IMP(行/秒) | DI(行/秒) |
| :--- | :--- | :--- | :--- |
| 商品種別 | 12,000 | 4,000 | 3,000 |
| 顧客詳細 | 8,000 | 4,000 | 2,500 |
| コンタクト履歴 | 10,000 | 5,000 | 2,000 |
注記 ファイル転送の処理時間は,無視できるものとする。
2. 移行計画
移行計画に先立ち,主要な移行工程・所要時間を表10にまとめた。
表10 主要な移行工程・所要時間(未完成)
| 期間 | 工程 | 内容 | 所要時間 |
| :--- | :--- | :--- | :--- |
| 準備期間 | ①新DB準備 | 新DBにDBオブジェクトを作成する。 | 5日 |
| | ②データ移行 | 現行DBのデータを新DBに移行する。 | (検討中) |
| | ③差分データ反映 | ②の後で追加又は更新されたデータを,新DBに反映する。 | (検討中) |
| 移行期間 | ④データ検証 | 現行DBと新DBのデータの整合性を検証する。 | 8時間 |
| | ⑤バックアップ | 新DBのフルバックアップを取得する。 | 10時間 |
| | ⑥判定 | 先行工程の結果を評価して,本番開始の可否を判定する。 | 2時間 |
| 監視期間 | ⑦本番開始 | APサーバからの接続先を新DBサーバに切り替える。 | 2時間 |
| | ⑧本番監視 | 障害,性能,業務データの整合性を監視し,問題があれば対処する。 | 1か月 |
3. データ移行処理方式設計
表10の工程②データ移行について,データ量が最も多い“コンタクト履歴”テーブルについて,次のように検討した。
(1) 表8と表9から,全行のデータ移行時間は,E&Iでは o 時間,DIでは, p 時間である。準備期間内のバッチ処理後のサービス停止時間を利用して移行処理を毎日4時間ずつ行うと,最短でも q 日掛かる。
(2) 準備期間内のデータ移行処理では,エクスポートツールに指定するSQL文を処理日別に用意すると,抽出条件の誤り,実行順の誤りなどが懸念される。そこで,移行データ抽出に使用する“抽出範囲”テーブルを現行DBに追加し,抽出処理日ごとに,行数が均等になるように支店コードの範囲を決めて登録することにした。“抽出範囲”テーブルのテーブル構造を図3に,エクスポートツールに指定するSQL文を図4に示す。
抽出範囲(抽出処理日,開始支店コード,終了支店コード)
図3 “抽出範囲”テーブルのテーブル構造
```sql
SELECT A.* FROM コンタクト履歴 A, 抽出範囲 B WHERE r AND s
```
図4 エクスポートツールに指定するSQL文(未完成)
(3) 表10の工程③差分データ反映で行う二つの処理を表11にまとめた。
なお,処理Aと処理Bは,相互に現行DB上の異なる行を対象とする。
表11 差分データ反映の処理内容とデータ移行方法(未完成)
| 処理 | 内容 | データ移行方法 |
| :--- | :--- | :--- |
| 処理A | “抽出範囲”テーブルの行の開始支店コードと終了支店コードの範囲内で,支店コードが一致する“案件”テーブルの行に対応し,かつ,次の条件に一致する“コンタクト履歴”テーブルの行を,新DBに追加する。
条件:登録日が抽出処理日の後である | v | | 処理B | “抽出範囲”テーブルの行の開始支店コードと終了支店コードの範囲内で,支店コードが一致する“案件”テーブルの行に対応し,かつ,次の条件に一致する“コンタクト履歴”テーブルの行の列値で新DBを更新する。
条件: t かつ u | w | 〔データ移行後の検証〕 DBの相互接続機能を利用して,現行DBと新DBのテーブルを比較し,SQL文を実行して全行,全列の値一致を確認する。二つの集合が同一であることを確かめる論理式と,対応するSQL文を,表12にまとめた。さらに,表12のSQL①を基に,“取引”テーブルを検証するためのSQL文を,図5に示す。 表12 論理式と対応するSQL文(未完成) | 論理式 | 対応するSQL文 | 記号 | | :--- | :--- | :--- | | A - B = φ かつ B - A = φ | SELECT COUNT(*) FROM (SELECT * FROM A EXCEPT SELECT * FROM B) R1
SELECT COUNT(*) FROM (SELECT * FROM B EXCEPT SELECT * FROM A) R2 | SQL①
SQL② | | (A ∪ B) - (A ∩ B) = φ | SELECT COUNT(*) FROM ((SELECT * FROM A x SELECT * FROM B) y (SELECT * FROM A z SELECT * FROM B)) R3 | SQL③ | 凡例 A ∪ B:AとBの和集合 A - B:AとBの差集合 A ∩ B:AとBの積集合 φ:空集合 ```sql SELECT COUNT(*) FROM ((SELECT * FROM OLD_DB.C01.取引) EXCEPT (SELECT * FROM NEW_DB.C01.取引)) R1 ``` 注記 OLD_DB:現行DBの識別子,NEW_DB:新DBの識別子,C01:スキーマ名 図5 “取引”テーブルを検証するためのSQL文
拡大図1 概念データモデル
拡大図2 テーブル構造(一部省略)
拡大表4 “スケジュール”テーブルのテーブル定義表(作成中)
条件:登録日が抽出処理日の後である | v | | 処理B | “抽出範囲”テーブルの行の開始支店コードと終了支店コードの範囲内で,支店コードが一致する“案件”テーブルの行に対応し,かつ,次の条件に一致する“コンタクト履歴”テーブルの行の列値で新DBを更新する。
条件: t かつ u | w | 〔データ移行後の検証〕 DBの相互接続機能を利用して,現行DBと新DBのテーブルを比較し,SQL文を実行して全行,全列の値一致を確認する。二つの集合が同一であることを確かめる論理式と,対応するSQL文を,表12にまとめた。さらに,表12のSQL①を基に,“取引”テーブルを検証するためのSQL文を,図5に示す。 表12 論理式と対応するSQL文(未完成) | 論理式 | 対応するSQL文 | 記号 | | :--- | :--- | :--- | | A - B = φ かつ B - A = φ | SELECT COUNT(*) FROM (SELECT * FROM A EXCEPT SELECT * FROM B) R1
SELECT COUNT(*) FROM (SELECT * FROM B EXCEPT SELECT * FROM A) R2 | SQL①
SQL② | | (A ∪ B) - (A ∩ B) = φ | SELECT COUNT(*) FROM ((SELECT * FROM A x SELECT * FROM B) y (SELECT * FROM A z SELECT * FROM B)) R3 | SQL③ | 凡例 A ∪ B:AとBの和集合 A - B:AとBの差集合 A ∩ B:AとBの積集合 φ:空集合 ```sql SELECT COUNT(*) FROM ((SELECT * FROM OLD_DB.C01.取引) EXCEPT (SELECT * FROM NEW_DB.C01.取引)) R1 ``` 注記 OLD_DB:現行DBの識別子,NEW_DB:新DBの識別子,C01:スキーマ名 図5 “取引”テーブルを検証するためのSQL文
設問一覧 & 解答・演習
まずは解答を作成してみましょう。「解答例を見る」をクリックするとIPA公式解答例と採点基準が開きます。
設問1 (1)記号・選択式
表4の太枠内に適切な字句を記入して太枠内を完成させよ。ただし,索引の種類と構成列の欄は全て埋まるとは限らない。また,a 〜 c に入れる適切な字句を答えよ。ただし,1〜999のような,値の上限・下限に関する制約は,検査制約では規定しないものとする。
※直接入力してください
設問1 (2)記号・選択式
表5中の d 〜 g に入れる適切な数値を答えよ。ここで,空き領域率は10%とする。
※直接入力してください
設問1 (3)記述問題
制限字数:35 字以内
表6のセキュリティ事故A, Bへの対策に関する“顧客基本”テーブル実装案の有効性を評価し,h,i に“○”又は“×”を記入せよ。また,セキュリティ事故Cにおいて,“顧客基本”テーブル実装案が有効でないのは,どのような場合か。20字以内で具体的に述べよ。さらに,顧客名の暗号化によるセキュリティ強化のトレードオフとして,性能の悪化,業務機能の劣化が懸念される。その事象を一つ挙げ,次の例に倣って35字以内で具体的に述べよ。
例:顧客情報の暗号化,復号のための処理時間が増加する。
例:顧客情報の暗号化,復号のための処理時間が増加する。
0 / 35 文字
設問2 (1)記号・選択式
表7中の j 〜 n に入れるテーブル名を,記入済みの例に倣って,全て答えよ。
※直接入力してください
設問2 (2)記号・選択式
“3. データ移行処理方式設計”本文中の o 〜 q に入れる適切な数値を答えよ。また,図4中の r,s に入れる適切な条件を,SQLの述語をそれぞれ一つだけ用いて答えよ。ここで,現在日付を表す予約語をCURRENT_DATEとする。
※直接入力してください
設問2 (3)記述問題
制限字数:20 字以内
表11中の t,u に入れる適切な条件を,それぞれ20字以内で答えよ。また,v,w に入れる適切なデータ移行方法を答えよ。
0 / 20 文字
設問3 (1)記号・選択式
表12中の x 〜 z に入れる適切な字句を答えよ。
※直接入力してください
設問3 (2)記述問題
制限字数:60 字以内
図5のSQL文では,データが正しく移行されていても,実行結果の列値がゼロにならない場合がある。その要因を二つ挙げ,それぞれ20字以内で述べよ。また,二つの要因に対するSQL文の修正内容を,それぞれ60字以内で述べよ。
0 / 60 文字
午後II長文記述の得点力を引き上げる定番対策書Amazon・楽天 公式提携
PR

IPA 厳選対策書徹底攻略 データベーススペシャリスト教科書 令和8年度株式会社わくわくスタディワールド 瀬戸 美月 著 / インプレス
DB徹底攻略株式会社わくわくスタディワールド 瀬戸 美月 著 / インプレス
徹底攻略 データベーススペシャリスト教科書 令和8年度
💡 推薦ポイント:午後I・午後IIの概念データモデル穴埋めや排他制御・性能設計の記述問題で確実に合格点を勝ち取る実践テクニックが満載です。
¥3,278(税込)
※本リンク先はプロモーション(アフィリエイト広告)が含まれています
【出題趣旨】IPA公式発表
【採点講評】IPA公式発表
本問に関連するデータベーススペシャリスト重要用語解説
本番形式・制限時間付きで演習する
平成28年 春期 午後II(2問中1問選択・120分)を実戦演習モードで通し解答し、総合採点を受けられます。