データベーススペシャリスト午後II 総合事例記述令和2年 10月
午後II 問1
問1 節電支援システムの設計,実装に関するデータベース設計・実装
テーマ:ホームエネルギーマネジメントシステムにおけるデータベースの設計・実装と性能検証
左右2分割表示:左側の問題文をスクロールしながら右側の設問に解答できます
長文事例本文
図表クリックで拡大問1 データベースの設計,実装に関する次の記述を読んで,設問1〜3に答えよ。
太陽光発電設備,空調設備などの住宅設備メーカであるJ社は,家庭の電気の使用状況を可視化するサービスの提供に向け,節電支援システムの構築を行っている。
〔業務の概要〕
(1) J社は,太陽光発電機器,配電盤,スマートメータ,空調機器などの機器との通信機能をもつコントローラを提供している。ユーザは,住居にコントローラを設置して,節電支援システムに住居及びコントローラの情報を登録する。
(2) コントローラは,J社とネットワーク接続し,住居内の機器から収集した買電,発電,使用電力,機器のログなどの情報をJ社に送信する。J社では,情報をデータベースに蓄積,加工してユーザに節電支援情報を提供する。その一つとして,使用電力量表示画面の例を図1に示す。図1では,使用電力量とその供給元の内訳(買電,発電など)が示される。
(3) 節電支援情報には,日射量を基に算出された標準発電量が含まれる。全国の800観測点で計測された日射量データを外部から取得する。
(4) 自治体,他の企業からの依頼を受けて,蓄積したデータを統計用に集計し,個人情報を含まないアドホック分析用のデータを抽出して提供する。
注記1 年月日は,‘年’,‘月’,‘日’のいずれかを選択し,対応する年,年月,年月日を指定する。
注記2 比較対象は,年月日が年の場合は‘前年’,‘前々年’など,月の場合は‘前月’,‘前年の同じ月’など,日の場合は‘前日’,‘先月の同じ日’などから選択する。
図1 使用電力量表示画面の例
〔節電支援システムのテーブル構造〕
設計済みのテーブル構造を図2に,主な列とその意味・制約を表1に示す。
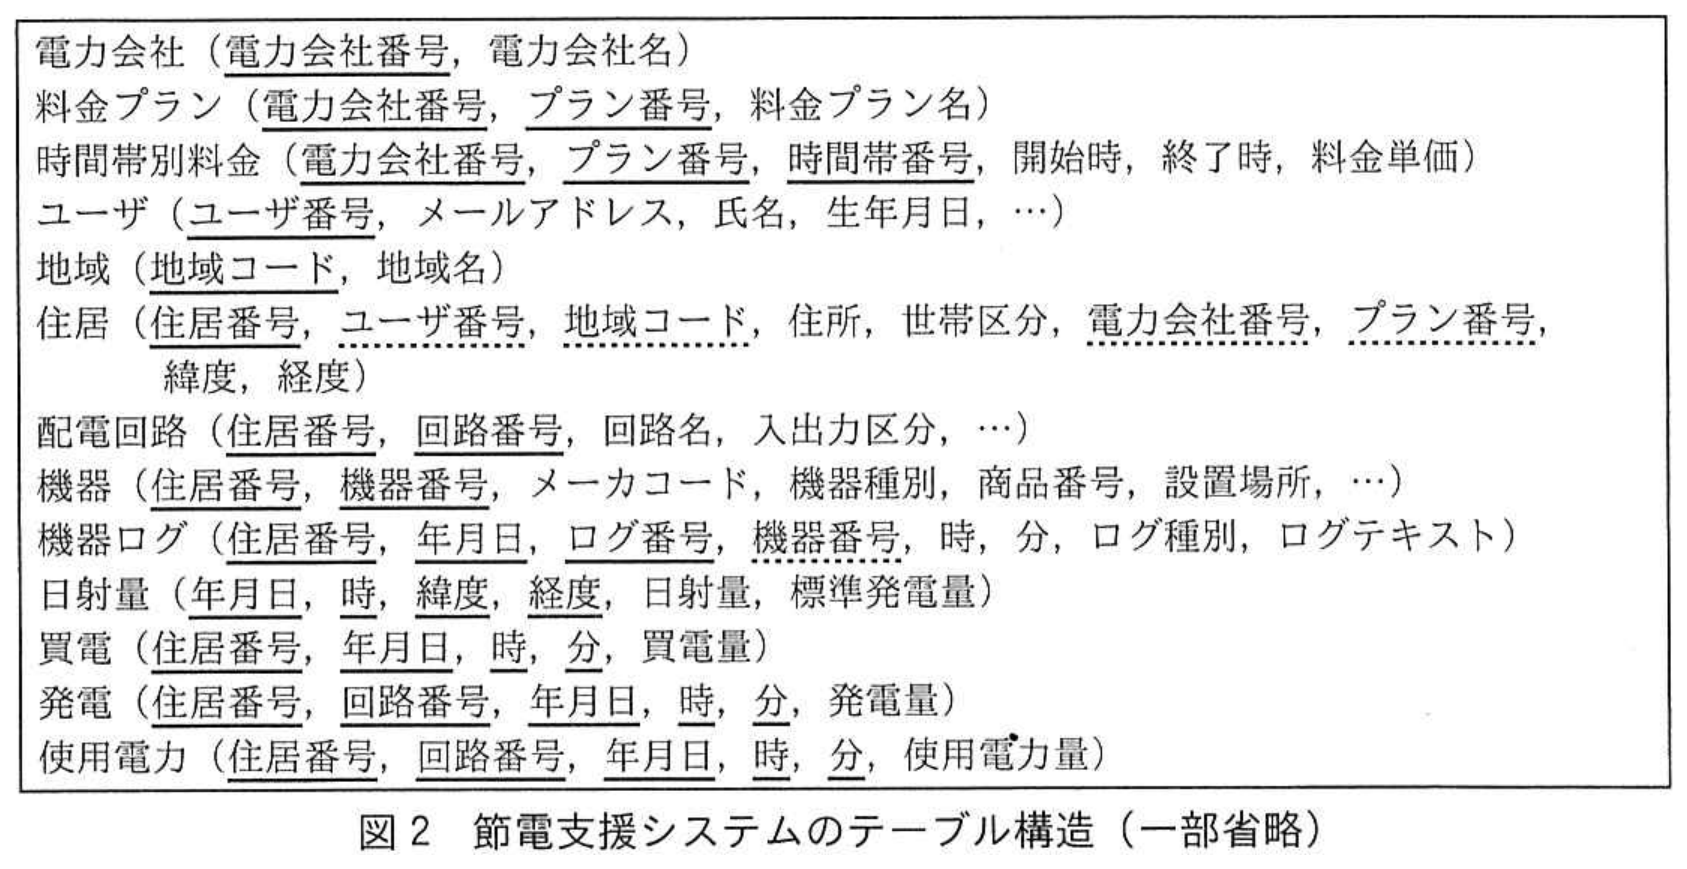 拡大
表1 主な列とその意味・制約
| 列名 | 意味・制約 |
| :--- | :--- |
| 時間帯番号 | 電力会社が料金プランごとに定める,1日を複数に区切った時間帯を一意に識別する番号(1〜99) |
| 開始時,終了時 | 時間帯の最初の時と最後の時を表す整数(0〜24)。最初の時間帯の開始時は0,最後の時間帯の終了時は24であり,最後の時間帯以外の終了時は,次の時間帯の開始時と一致する。 |
| 料金単価 | 電力量1kWh当たりの買電単価 |
| 地域コード | 複数の市町村をまとめた地域を一意に識別するコード(4桁の半角英数字) |
| 住居番号 | サービスに登録された住居を一意に識別する番号(1〜999,999) |
| 世帯区分 | 住居の世帯構成,住宅の形態を表す区分(3桁の半角英数字) |
| 緯度,経度 | 地図上の位置をそれぞれ精度10,位取り7の10進数で表す。 |
| ログ番号 | 住居ごと年月日ごとに機器のログを一意に識別する番号(1〜999,999,999) |
| ログ種別 | 起動,停止,測定など,ログの種類を表すコード(4桁の半角英数字) |
| 回路番号 | 住居内の分電盤内の回路を一意に識別する番号(1〜99) |
| 買電量 | 電力会社から供給を受けた電力量(単位kWh,0.000〜9,999,999.999) |
| 発電量 | 住居の発電設備で発電された電力量(単位kWh,0.000〜9,999,999.999) |
| 使用電力量 | 住居内で消費した電力量(単位kWh,0.000〜9,999,999.999) |
| 日射量 | 各観測点における年月日,時ごとの日射量(単位kW/m²,0〜999,999) |
| 標準発電量 | 日射量を基に計算した標準発電量(単位kWh,0.000〜9,999,999.999) |
〔節電支援システムの処理〕
節電支援情報の提供,アドホック分析の処理の例を,表2に示す。
表2 処理の例
| 処理名 | 内容 |
| :--- | :--- |
| 処理1 | 指定された住居番号について,図1の使用電力量表示画面の例に示されたグラフを表示するためのデータを抽出する。当月の買電,発電,当月及び比較対象の使用電力を対象に,年月日ごとにそれぞれ発電量,買電量,使用電力量を集計する。 |
| 処理2 | 指定された住居番号,年月日,比較対象住居(同じ地域,同じ世帯区分,同じ地域かつ同じ世帯区分のいずれか)について,1日の使用電力量の比較対象住居中の順位を求めて,住居番号,対象住居数,順位を抽出する。 |
| 処理3 | 指定された住居番号,年月日,時について,住居番号,発電量,平均標準発電量を抽出する。平均標準発電量は,住居ごとに住居の半径10km以内の地点のうち,住居から距離が近い上位2位以上の地点の標準発電量の平均値である。 |
| 処理4 | 指定された年月について,全住居を対象に,地域ごとに,各住居の1か月間の使用電力量の合計を大きい方から順序付けし,順序に沿って住居数が均等になるように5階級に分ける。階級に1〜5の階級番号を付け,地域コード,地域名,階級番号,平均使用電力量を抽出する。 |
| 処理5 | 指定された住居番号,年月日,ログ種別について,全機器の機器ログを対象に,住居番号,年月日,ログ番号,メーカコード,機器種別,ログテキストを抽出する。 |
〔RDBMSの仕様〕
1. テーブル・索引
(1) RDBMSとストレージ間の入出力単位をページという。
(2) 同じページに異なるテーブルのデータが格納されることはない。
(3) NOT NULL制約を指定しない列には,1バイトのフラグが付加される。
(4) 列の主なデータ型は,表3のとおりである。
(5) 索引にはユニーク索引と非ユニーク索引がある。
(6) DMLのアクセスパスは,RDBMSによって索引探索又は表探索が選択される。索引探索が選択されるためには,WHERE句又はON句のANDだけで結ばれた一つ以上の等値比較の述語の対象列が,索引キーの全体又は先頭から連続した一つ以上の列に一致していなければならない。
(7) 索引探索では,ページの読込みはバッファを介して行われ,バッファの置換えはLRU方式で行われる。同じページ長のテーブルは,一つのバッファを共有する。バッファごとにバッファサイズを設定する。
(8) 索引のキー値の順番と,キー値が指す行の物理的な並び順が一致している割合(以下,クラスタ率という)が高いほど,隣接するキー値が指す行が同じページに格納されている割合が高い。
表3 列の主なデータ型
| データ型 | 説明 |
| :--- | :--- |
| CHAR(n) | n文字の半角固定長文字列(1≦n≦255)。文字列がn字未満の場合は,文字列の後方に半角の空白を埋めてnバイトの領域に格納される。 |
| NCHAR(n) | n文字の全角固定長文字列(1≦n≦127)。文字列がn字未満の場合は,文字列の後方に全角の空白を埋めて“n×2”バイトの領域に格納される。 |
| NCHAR VARYING(n) | 最大n文字の全角可変長文字列(1≦n≦4,000)。“値の文字数×2”バイトの領域に格納され,4バイトの制御情報が付加される。 |
| SMALLINT | -32,768〜32,767の範囲の整数。2バイトの領域に格納される。 |
| INTEGER | -2,147,483,648〜2,147,483,647の範囲の整数。4バイトの領域に格納される。 |
| DECIMAL(m,n) | 精度m(1≦m≦31),位取りn(0≦n≦m)の10進数。“m÷2+1”の小数部を切り捨てたバイト数の領域に格納される。 |
| DATE | 0001-01-01〜9999-12-31の範囲内の日付。4バイトの領域に格納される。 |
2. ウィンドウ関数
RDBMSがサポートする主なウィンドウ関数を,表4に示す。
表4 RDBMSがサポートする主なウィンドウ関数
| 関数の構文 | 説明 |
| :--- | :--- |
| RANK() OVER([PARTITION BY e1] ORDER BY e2 [ASC|DESC]) | 区画化列をPARTITION BY句のe1に,ランク化列をORDER BY句のe2に指定する。対象となる行の集まりを,区画化列の値が等しい部分(区画)に分割し,各区画内で行をランク化列によって順序付けした順位を,1から始まる番号で返す。同値は同順位として,同順位の数だけ順位をとばす。(例:1,2,2,4,…) |
| NTILE(e1) OVER([PARTITION BY e2] ORDER BY e3 [ASC|DESC]) | 階級数をNTILEの引数e1に,区画化列をPARTITION BY句のe2に,階級化列をORDER BY句のe3に指定する。対象となる行の集まりを,区画化列の値が等しい部分(区画)に分割し,各区画内で行を階級化列によって順序付けし,行数が均等になるように順序に沿って階級数分の等間隔の部分(タイル)に分割する。各タイルに,順序に沿って1からの連続する階級番号を付け,各行の該当する階級番号を返す。 |
注記1 関数の構文の[ ]で囲われた部分は,省略可能であることを表す。
注記2 PARTITION BY句を省略した場合,関数の対象行の集まり全体が一つの区画となる。
注記3 ORDER BY句の[ASC|DESC]を省略した場合,ASCを指定した場合と同じ動作となる。
3. クラスタ構成のサポート
(1) シェアードナッシング方式のクラスタ構成をサポートする。クラスタは複数のノードで構成され,各ノードには専用のディスク装置をもつ。
(2) ノードへのデータの配置方法には複製,分散の二つがあり,テーブルごとにどちらかを指定する。複製は,各ノードにテーブルの全行を配置する方法である。分散は,一つ又は複数の列を分散キーとし,その値に基づいてRDBMS内部で生成するハッシュ値によって,各ノードにデータを配置する方法である。
(3) データベースへの要求は,いずれか一つのノードで受け付ける。要求を受け付けたノードは,要求を解析し,自ノードに配置されているデータへの処理は自ノードで処理を行う。自ノードに配置されていないデータへの処理は,当該データが配置されている他ノードに処理を依頼し,結果を受け取る。
〔システムの構成〕
(1) 複数のAPサーバと複数のDBサーバから成る。ユーザは,APサーバを介して操作を行う。APサーバはいずれか一つのDBサーバにアクセスする。
(2) データベースは,シェアードナッシングのクラスタ構成とし,20ノードを配置する。各ノードには同じ仕様のDBサーバを配置する。クラスタ構成によるDBサーバ全体のTPSは,ノード数に比例することを確認している。
(3) 機器ログ,買電,発電,使用電力の各テーブルは,配置方法を分散にし,住居番号を分散キーに指定する。それ以外のテーブルの配置方法は複製にする。
〔データベースの物理設計〕
1. テーブルの行数,所要量見積り
次の前提で主なテーブルの行数,所要量を見積もり,表5を作成した。
(1) 日射量,機器ログ,買電,発電,使用電力は,2年前の1月1日から現在までで,最大3年分のデータを保存する。1年を360日として行数を見積もる。
(2) どのテーブルもページ長を2,000バイト,空き領域率を10%とする。
(3) 見積ページ数は,“見積行数÷ページ当たり平均行数”の小数部を切り上げる。ページ当たり平均行数は,“ページ長×(1-空き領域率)÷平均行長”の小数部を切り捨てる。
(4) 所要量は,“見積ページ数×ページ長”で算出する。
表5 主なテーブルの見積行数・所要量
| テーブル名 | 見積りの前提 | 見積行数 | 平均行長(バイト) | 見積ページ数 | 所要量(バイト) |
| :--- | :--- | :--- | :--- | :--- | :--- |
| 地域 | 1,000件 | 1,000 | 10 | 6 | 12k |
| 住居 | 100,000件 | 100,000 | 100 | 5,556 | 12M |
| 配電回路 | 8件/住居 | 800,000 | 100 | 44,445 | 89M |
| 機器 | 10件/住居 | 1,000,000 | 300 | 166,667 | 334M |
| 機器ログ | 1日200件/住居 | 21,600,000,000 | 80 | 981,818,182 | 1,964G |
| 日射量 | 1日12件/観測点 | 10,368,000 | 25 | 144,000 | 288M |
| 買電 | 1日100件/住居 | 10,800,000,000 | 18 | 108,000,000 | 216G |
| 発電 | 1日40件/住居 | 4,320,000,000 | 20 | 48,000,000 | 96G |
| 使用電力 | 1日500件/住居 | 54,000,000,000 | 20 | 600,000,000 | 1,200G |
注記 表中の単位kは1,000,Mは100万,Gは10億を表す。
2. テーブル定義書の作成
次の方針に基づいてテーブル定義書を作成した。その一部を表6〜8に示す。
(1) データ型欄には,適切なデータ型,適切な長さ,精度,位取りを記入する。
(2) NOT NULL欄には,NOT NULL制約がある場合だけYを記入する。
(3) 格納長欄には,RDBMSの仕様に従って,格納長を記入する。
(4) 索引の種類には,P(主キーの索引),U(ユニーク索引),NU(非ユニーク索引)のいずれかを記入し,各構成列欄には,構成列の定義順に1からの連番を記入する。該当する索引がなければどちらも空欄にする。
(5) 主キー及び外部キーには,索引を定義する。
表6 “買電”テーブルのテーブル定義書
| 項目 列名 | データ型 | NOT NULL | 格納長(バイト) | 索引の種類と構成列 P |
| :--- | :--- | :---: | :---: | :---: |
| 住居番号 | INTEGER | Y | 4 | 1 |
| 年月日 | DATE | Y | 4 | 2 |
| 時 | SMALLINT | Y | 2 | 3 |
| 分 | SMALLINT | Y | 2 | 4 |
| 買電量 | DECIMAL(10,3) | Y | 6 | |
表7 “発電”テーブルのテーブル定義書
| 項目 列名 | データ型 | NOT NULL | 格納長(バイト) | 索引の種類と構成列 P |
| :--- | :--- | :---: | :---: | :---: |
| 住居番号 | INTEGER | Y | 4 | 1 |
| 回路番号 | SMALLINT | Y | 2 | 2 |
| 年月日 | DATE | Y | 4 | 3 |
| 時 | SMALLINT | Y | 2 | 4 |
| 分 | SMALLINT | Y | 2 | 5 |
| 発電量 | DECIMAL(10,3) | Y | 6 | |
表8 “使用電力”テーブルのテーブル定義書
| 項目 列名 | データ型 | NOT NULL | 格納長(バイト) | 索引の種類と構成列 P |
| :--- | :--- | :---: | :---: | :---: |
| 住居番号 | INTEGER | Y | 4 | 1 |
| 回路番号 | SMALLINT | Y | 2 | 2 |
| 年月日 | DATE | Y | 4 | 3 |
| 時 | SMALLINT | Y | 2 | 4 |
| 分 | SMALLINT | Y | 2 | 5 |
| 使用電力量 | DECIMAL(10,3) | Y | 6 | |
3. テーブル構造の検討
表2の処理1では,ストレージからの読込みに時間が掛かるおそれがあるので,次の前提で読込みページ数の予測を行い,必要であれば対策を講じる。
(1) 前提
・図1の使用電力量表示画面で,年月日の区分を‘月’,対応する年月を‘2019年4月’,比較対象を‘前年の同じ月’として照会を行う。
・“買電”,“発電”,“使用電力”の各テーブルには,住居番号当たりの行数は均等で,どのページにも最大行数分の行が格納されているものとする。
・アクセスパスは,どのテーブルも索引探索が選択されるものとする。索引のバッファヒット率は,100%とする。
(2) 予測
・表9に使用電力量表示画面における読込みページ数の予測をまとめた。
・探索行数は,選択条件に一致する行を求めるために読み込む行数である。
・最小読込みページ数は,クラスタ率が最も高い場合の読込みページ数で,“a ÷ b”の小数部を切り上げた値に等しい。
・最大読込みページ数は,クラスタ率が最も低い場合の読込みページ数で,c に一致する。
・クラスタ率50%の読込みページ数を平均読込みページ数といい,“(最小読込みページ数+最大読込みページ数)×50%”の小数部を切り上げる。
表9 使用電力量表示画面における読込みページ数の予測(未完成)
| テーブル名 | 結果行数 | 探索行数 | 最小読込みページ数 | 最大読込みページ数 |
| :--- | :---: | :---: | :---: | :---: |
| 買電 | 30 | 3,000 | | |
| 発電 | 30 | 43,200 | | |
| 使用電力 | 60 | d | e | f |
注記 網掛け部分は表示していない。
(3) 対策
表9の結果から照会の応答時間が長すぎると判断した。そこで,次の対策を行うことで,平均読込みページ数を100以下にすることにした。
・照会対象となる電力量を集計した一つ又は複数のテーブルを追加する。
・追加したテーブルには,前日までの集計行を夜間バッチ処理で追加する。
・当日の電力量は“買電”,“発電”,“使用電力”の各テーブルから求め,それ以外の電力量は追加したテーブルから求める。
〔問合せの検討〕
1. 表2の処理3の問合せ
処理3の問合せ内容を表10に整理し,問合せに用いるSQL文を図3に作成した。問合せ内容は,次の要領で記入し,内容のない欄は“-”にする。
(1) 行ごとに構成要素となる問合せを記述する。結果を他の問合せで参照する場合は,行に固有の名前(以下,問合せ名という)を付ける。
(2) 列名又は演算には,テーブルから射影する列名又は演算(MAX関数,AVG関数など)によって求まる項目を“項目名=[演算の概要]”の形式で記述する。
(3) テーブル名又は問合せ名には,参照するテーブル名又は問合せ名を記入する。
(4) 選択又は結合の内容には,テーブル名又は問合せ名ごとの選択条件,結合の具体的な方法と結合条件を記入する。
表10 処理3の問合せ内容
| 問合せ名 | 列名又は演算 | テーブル名又は問合せ名 | 選択又は結合の内容 |
| :---: | :--- | :--- | :--- |
| W1 | 住居番号,年月日,時,標準発電量,距離=[住居と日射量観測点の距離] | 住居,日射量 | ① 住居から指定された住居番号に一致する行を選択
② 日射量から指定された年月日,時に一致する行を選択
③ ①と②の結果の直積から住居と日射量観測点の距離が10km以下の行を選択 | | W2 | 住居番号,年月日,時,標準発電量,ランク=[距離を昇順に並べた順位] | W1 | W1の全行を選択 | | W3 | 住居番号,年月日,時,平均標準発電量=[住居番号,年月日,時ごとの標準発電量の平均] | W2 | ランクが2以下の行を選択 | | W4 | 住居番号,年月日,時,時間発電量=[住居番号,年月日,時ごとの発電量の合計] | 発電 | 住居番号,年月日,時が指定値に一致する行を選択 | | - | 住居番号,年月日,時,平均標準発電量,時間発電量 | W3,W4 | ① W3の全行を選択
② ①の結果とW4を住居番号,年月日,時で内結合 |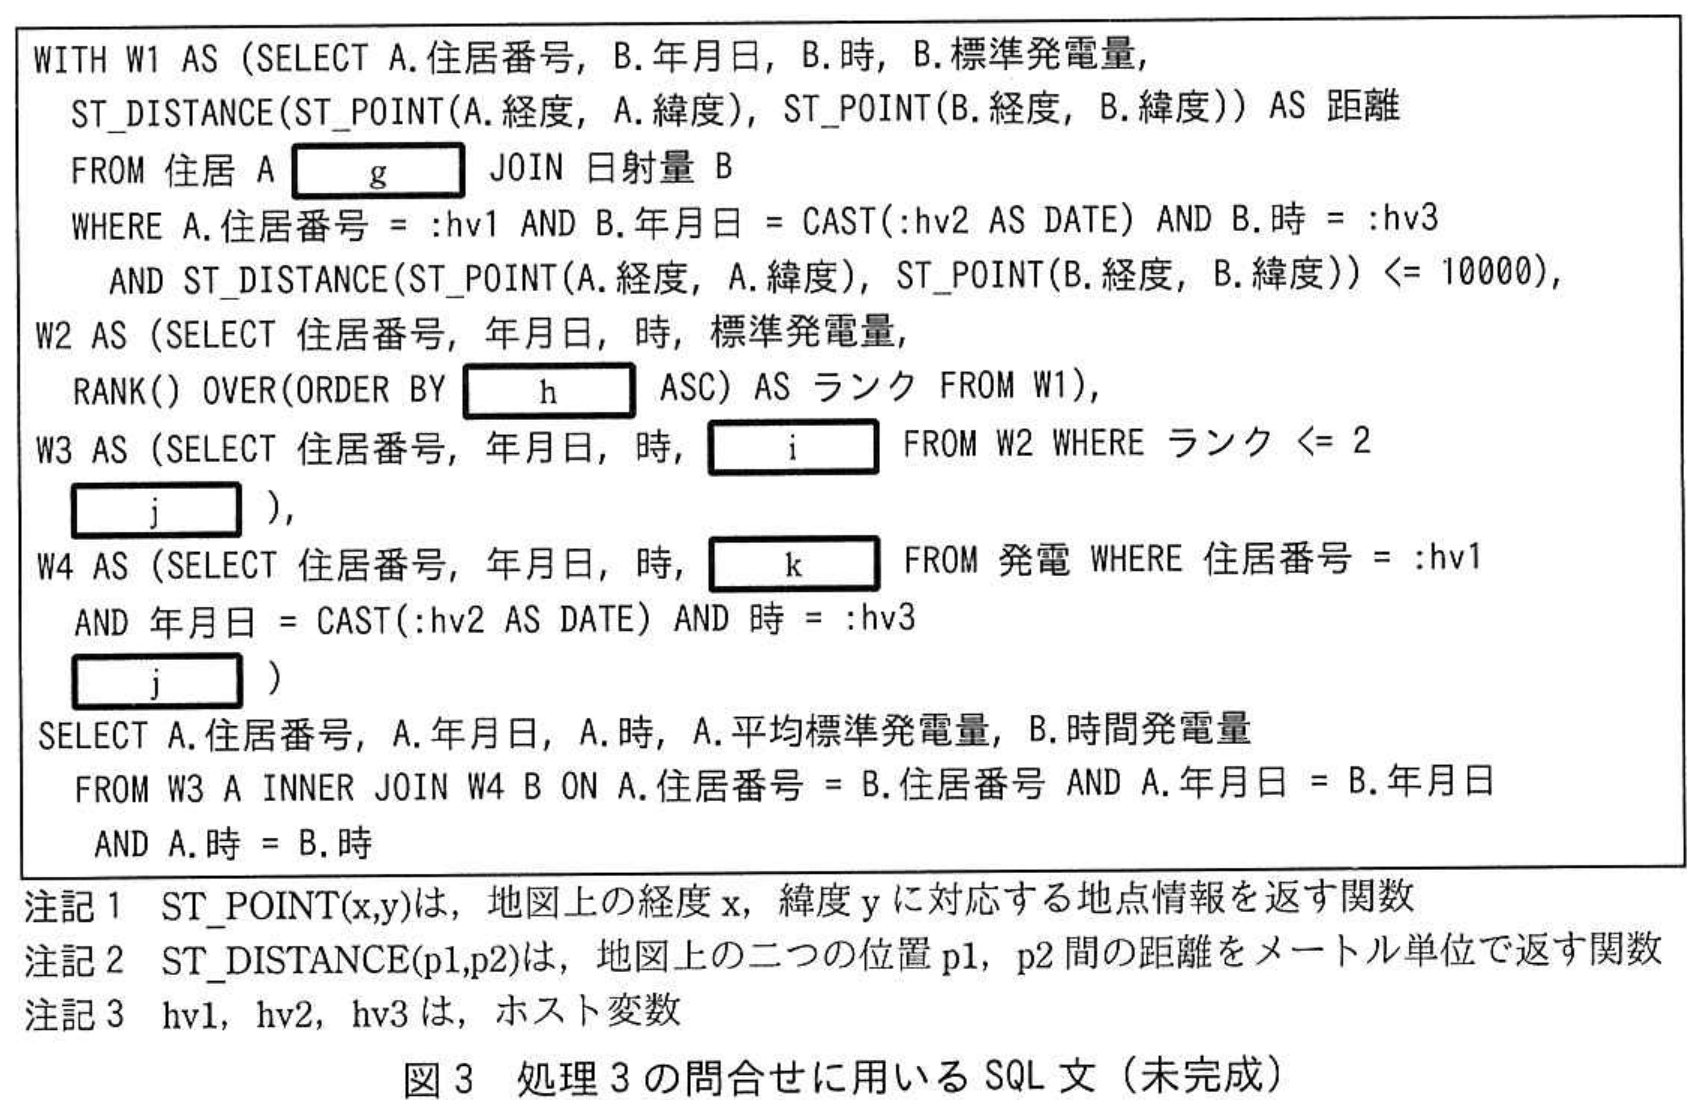 拡大
2. 表2の処理4の問合せ
処理3と同様に,処理4の問合せ内容を表11に整理し,問合せに用いるSQL文を図4に作成した。
表11 処理4の問合せ内容(未完成)
| 問合せ名 | 列名又は演算 | テーブル名又は問合せ名 | 選択又は結合の内容 |
| :---: | :--- | :--- | :--- |
| W1 | 地域コード,住居番号,合計使用電力量=[地域コード,住居番号ごとの使用電力量の合計] | 使用電力,住居 | ① 使用電力から年月日の年月が指定された年月に一致する行を選択
② l | | W2 | 地域コード,住居番号,合計使用電力量,階級番号=[地域コードによって分割した区画ごとに,各住居の合計使用電力量を大きい方から順序付けし,順序に沿って住居数が均等になるように5階級に分けて付与した1〜5の番号] | W1 | W1の全行を選択 | | W3 | 地域コード,階級番号,m | W2 | W2の全行を選択 | | - | 地域コード,地域名,階級番号,平均使用電力量 | W3,地域 | ① n
② o |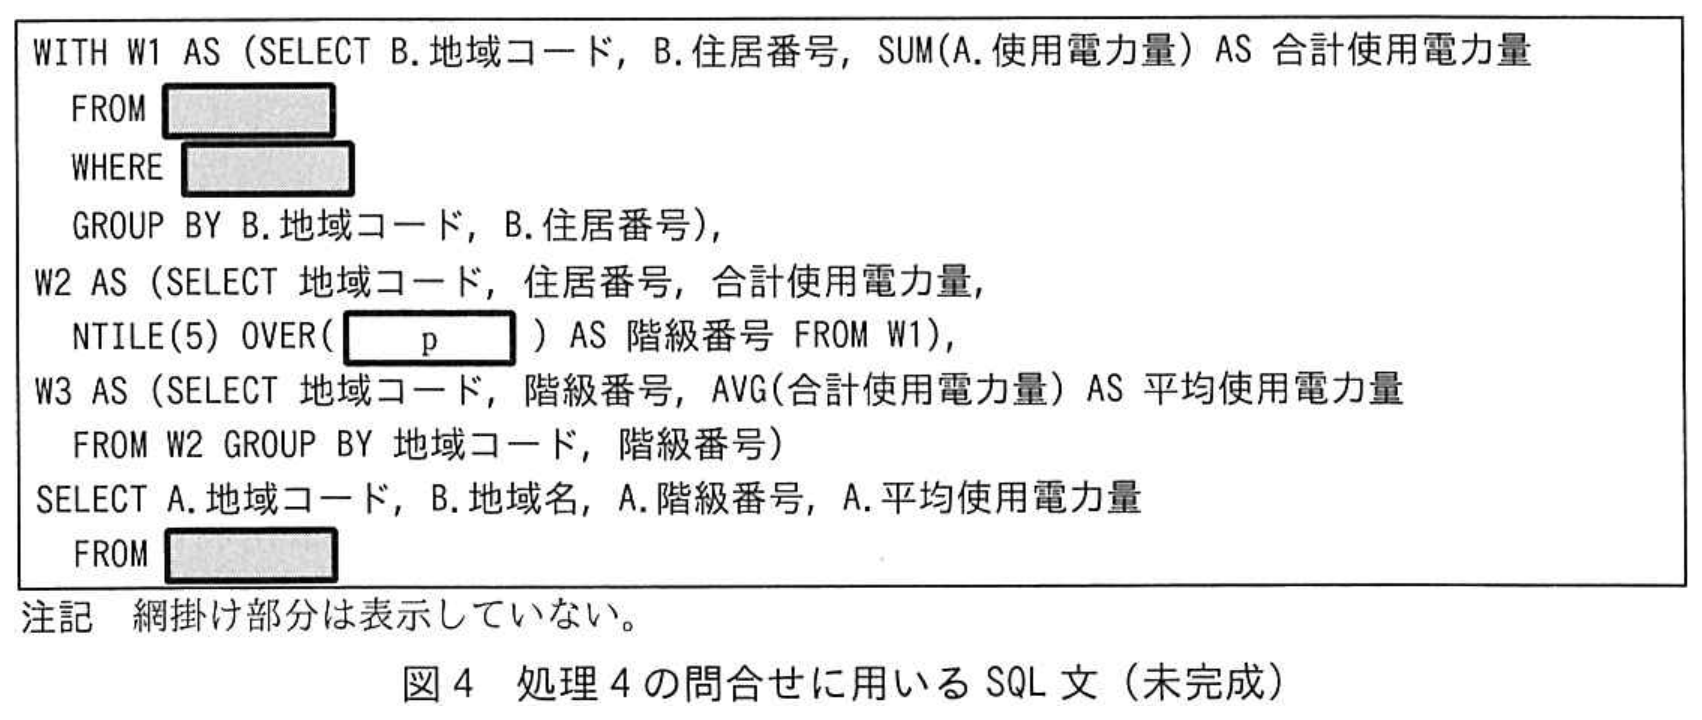 拡大
〔性能テストの実施〕
ピーク時の処理性能を見積もった上で,性能テストを実施して検証する。
1. 性能テストの方針
(1) DBサーバ2台による2ノードのクラスタ構成のテスト環境を使用する。各DBサーバの仕様は本番のDBサーバと同じにする。また,ページ長が2,000バイトのバッファには,480,000ページ分のサイズを設定する。
(2) ピーク時の5分間に,表2中の複数の処理が,それぞれ複数同時にDBサーバ上で実行される状況を模してテストを行い,応答時間を計測して見積りと比較する。処理は,それぞれピーク時の想定に基づきDBサーバごとに50〜100の多重度で実行する。
(3) 表5の見積行数を基に,テスト環境の特性を踏まえて,適切な行数,適切な列値,参照整合性を備えたテストデータを作成する。
2. 応答時間の見積り
次の前提に基づいて,トランザクション当たりの応答時間見積りを表12にまとめた。
(1) ページ当たりのバッファへのアクセス時間は,平均0.1ミリ秒である。
(2) ページ当たりのストレージへのアクセス時間は,平均8ミリ秒である。
(3) 各DBサーバは,本テストにおける最大の同時並行処理数を上回る並行処理能力を備えている。
(4) DBサーバ上の実行待ち時間,ネットワーク待ち時間,CPU待ち時間は考慮しない。
表12 トランザクション当たりの応答時間見積り
| 処理名 | トランザクション当たりのアクセスページ数 | バッファヒット率 | トランザクション当たりの応答時間(ミリ秒) |
| :--- | :---: | :---: | :---: |
| 処理2 | 5,000 | 40% | 24,200 |
| 処理3 | 100 | 90% | 89 |
| 処理5 | 200 | 50% | 810 |
3. テストデータの作成
主なテーブルのテストデータの作成要領を表13に示す。
表13 主なテーブルのテストデータの作成要領
| テーブル名 | 行数 | テストデータの作成要領 |
| :--- | :--- | :--- |
| 住居 | 見積行数の10分の1 | ・住居番号は,1からの連番を付与する。
・住所などの文字列型の列には,その列の平均的な文字数を基準にランダムな文字列を生成して設定する。
・外部キー列には,参照先のテーブルの主キー列に存在する値を設定する。
・地域コードには,適切な列値を設定する。 | | 配電回路 | 同上 | 住居に存在する住居番号ごとに,1〜8の回路番号を順に設定して行を追加する。回路名など他の列には任意の設定をする。 | | 買電 | 同上 | 住居に存在する住居番号ごと,3年分の年月日ごとに,一定間隔の時,分を設定し,住居番号,年月日,時,分順に行を追加する。 | | 発電,使用電力 | 同上 | 配電回路に存在する住居番号,回路番号ごと,3年分の年月日ごとに,一定間隔の時,分を設定し,住居番号,回路番号,年月日,時,分順に行を追加する。 | | 機器ログ | 同上 | 住居に存在する住居番号ごと,3年分の連続する年月日ごとに,連続するログ番号を設定して,住居番号,年月日順に,1日当たり平均200行を追加する。 | | 日射量 | 見積行数と同数 | 800地点の緯度,経度は,地図上均等に分散するようにし,緯度・経度の組ごとに,3年分の年月日,時の行を追加する。 | 4. 性能テストの結果 性能テストの実行結果を図5に示す。図5の処理の実行時間帯の列は,10秒間を表し,網掛け部分は,その処理が1回以上実行された時間帯を表す。応答時間の実測値を表12の見積りと比較したところ,次の差異があった。 差異1:処理5は,どの時間帯でもバッファヒット率が90%を超え,応答時間は見積りの約50分の1だった。 差異2:処理3は,図5中の①及び②の時間帯で応答時間が見積りよりも長かった。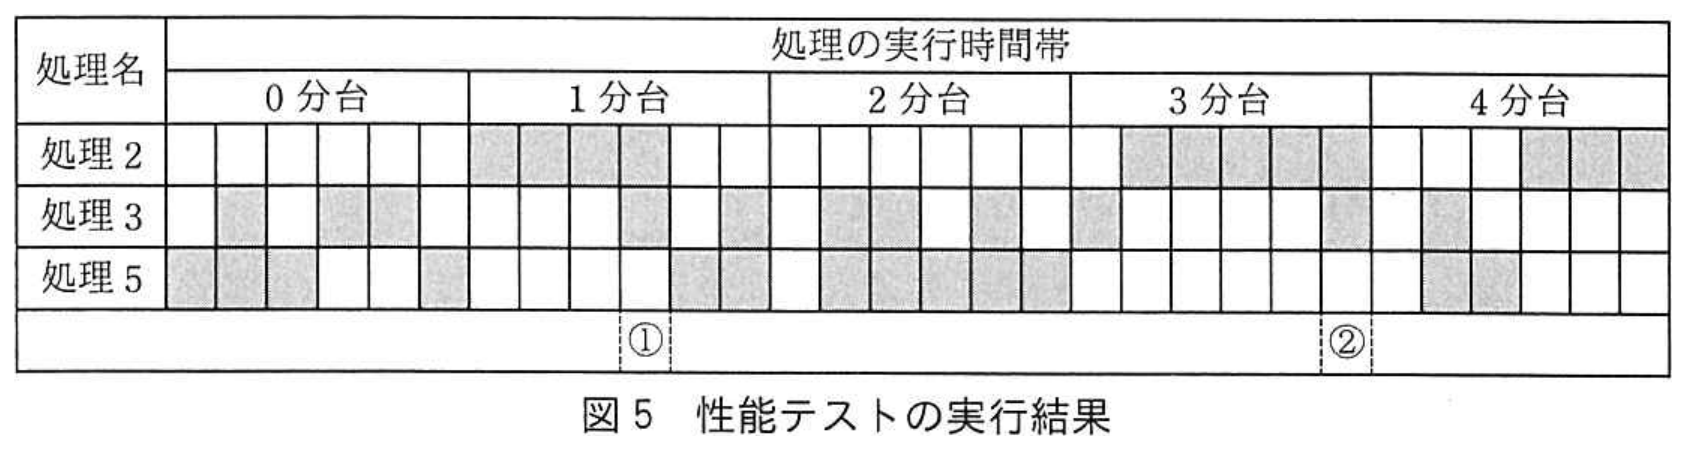 拡大
拡大図2 節電支援システムのテーブル構造(一部省略)
② 日射量から指定された年月日,時に一致する行を選択
③ ①と②の結果の直積から住居と日射量観測点の距離が10km以下の行を選択 | | W2 | 住居番号,年月日,時,標準発電量,ランク=[距離を昇順に並べた順位] | W1 | W1の全行を選択 | | W3 | 住居番号,年月日,時,平均標準発電量=[住居番号,年月日,時ごとの標準発電量の平均] | W2 | ランクが2以下の行を選択 | | W4 | 住居番号,年月日,時,時間発電量=[住居番号,年月日,時ごとの発電量の合計] | 発電 | 住居番号,年月日,時が指定値に一致する行を選択 | | - | 住居番号,年月日,時,平均標準発電量,時間発電量 | W3,W4 | ① W3の全行を選択
② ①の結果とW4を住居番号,年月日,時で内結合 |
拡大図3 処理3の問合せに用いるSQL文(未完成)
② l | | W2 | 地域コード,住居番号,合計使用電力量,階級番号=[地域コードによって分割した区画ごとに,各住居の合計使用電力量を大きい方から順序付けし,順序に沿って住居数が均等になるように5階級に分けて付与した1〜5の番号] | W1 | W1の全行を選択 | | W3 | 地域コード,階級番号,m | W2 | W2の全行を選択 | | - | 地域コード,地域名,階級番号,平均使用電力量 | W3,地域 | ① n
② o |
拡大図4 処理4の問合せに用いるSQL文(未完成)
・住所などの文字列型の列には,その列の平均的な文字数を基準にランダムな文字列を生成して設定する。
・外部キー列には,参照先のテーブルの主キー列に存在する値を設定する。
・地域コードには,適切な列値を設定する。 | | 配電回路 | 同上 | 住居に存在する住居番号ごとに,1〜8の回路番号を順に設定して行を追加する。回路名など他の列には任意の設定をする。 | | 買電 | 同上 | 住居に存在する住居番号ごと,3年分の年月日ごとに,一定間隔の時,分を設定し,住居番号,年月日,時,分順に行を追加する。 | | 発電,使用電力 | 同上 | 配電回路に存在する住居番号,回路番号ごと,3年分の年月日ごとに,一定間隔の時,分を設定し,住居番号,回路番号,年月日,時,分順に行を追加する。 | | 機器ログ | 同上 | 住居に存在する住居番号ごと,3年分の連続する年月日ごとに,連続するログ番号を設定して,住居番号,年月日順に,1日当たり平均200行を追加する。 | | 日射量 | 見積行数と同数 | 800地点の緯度,経度は,地図上均等に分散するようにし,緯度・経度の組ごとに,3年分の年月日,時の行を追加する。 | 4. 性能テストの結果 性能テストの実行結果を図5に示す。図5の処理の実行時間帯の列は,10秒間を表し,網掛け部分は,その処理が1回以上実行された時間帯を表す。応答時間の実測値を表12の見積りと比較したところ,次の差異があった。 差異1:処理5は,どの時間帯でもバッファヒット率が90%を超え,応答時間は見積りの約50分の1だった。 差異2:処理3は,図5中の①及び②の時間帯で応答時間が見積りよりも長かった。
拡大図5 性能テストの実行結果
設問一覧 & 解答・演習
まずは解答を作成してみましょう。「解答例を見る」をクリックするとIPA公式解答例と採点基準が開きます。
設問1 (1)記号・選択式
表2の処理2では,比較対象住居を索引内で絞り込むようにしたい。そのために,“住居”テーブルに,主キー,外部キー以外の索引を一つ定義する。索引を構成する列名を定義順に答えよ。
※直接入力してください
設問1 (2) ①記号・選択式
予測について,本文中の a 〜 c に入れる適切な字句を,本文中の用語を用いて答えよ。また,表9中の d 〜 f に入れる適切な数値を答えよ。
※直接入力してください
設問1 (2) ②記号・選択式
対策について,追加するテーブルのテーブル構造を答えよ。解答に当たっては,巻頭の表記ルールに従うこと。
なお,“列1番,列2番,列3番,列4番”のように,一定の規則で連続する列名は,“列1番,…,列4番”のように間を省略してもよい。また,買電,発電,使用電力を区別する列を用いる場合は,列名を“電力区分”とし,データ型をCHAR(1)とせよ。
なお,“列1番,列2番,列3番,列4番”のように,一定の規則で連続する列名は,“列1番,…,列4番”のように間を省略してもよい。また,買電,発電,使用電力を区別する列を用いる場合は,列名を“電力区分”とし,データ型をCHAR(1)とせよ。
※直接入力してください
設問1 (2) ③記号・選択式
②のテーブルを使用して使用電力量照会を行う場合の読込みページ数予測を行い,②のテーブルの最小読込みページ数,最大読込みページ数を答えよ。
※直接入力してください
設問2 (1)記号・選択式
図3中の g 〜 k に入れる適切な字句を答えよ。
※直接入力してください
設問2 (2)記号・選択式
表11中の l 〜 o ,図4中の p に入れる適切な字句を答えよ。
※直接入力してください
設問3 (1) ①記述問題
制限字数:50 字以内
“住居”テーブルの行数は見積行数の10分の1の行数となっている。この行数で本番環境の性能が推測できる理由を50字以内で述べよ。
0 / 50 文字
設問3 (1) ②記述問題
制限字数:50 字以内
表13の下線部について,地域コードに値を設定する上で留意すべき事項を具体的に50字以内で述べよ。
0 / 50 文字
設問3 (2)記述問題
制限字数:50 字以内
“4. 性能テストの結果”の差異1,差異2について,最も可能性が高いと考えられる差異の発生原因を,それぞれ具体的に50字以内で述べよ。
0 / 50 文字
午後II長文記述の得点力を引き上げる定番対策書Amazon・楽天 公式提携
PR

IPA 厳選対策書徹底攻略 データベーススペシャリスト教科書 令和8年度株式会社わくわくスタディワールド 瀬戸 美月 著 / インプレス
DB徹底攻略株式会社わくわくスタディワールド 瀬戸 美月 著 / インプレス
徹底攻略 データベーススペシャリスト教科書 令和8年度
💡 推薦ポイント:午後I・午後IIの概念データモデル穴埋めや排他制御・性能設計の記述問題で確実に合格点を勝ち取る実践テクニックが満載です。
¥3,278(税込)
※本リンク先はプロモーション(アフィリエイト広告)が含まれています
【出題趣旨】IPA公式発表
【採点講評】IPA公式発表
本問に関連するデータベーススペシャリスト重要用語解説
本番形式・制限時間付きで演習する
令和2年 10月 午後II(2問中1問選択・120分)を実戦演習モードで通し解答し、総合採点を受けられます。